Named Entity Recognition
Định nghĩa
Named Entity Recognition là tác vụ nhận diện và gán nhãn các thực thể trong văn bản, ví dụ người, tổ chức, địa điểm, sản phẩm hoặc ngày tháng.
Cách hiểu bằng lời của tôi
NER không gán nhãn cho cả câu mà gán nhãn cho token/span. Vì tokenizer có thể tách một từ thành nhiều subword, phần align label rất quan trọng.
Cần biết
- Đây là token-level task.
- Trong Information Extraction, NER là bước nhận diện entity mentions như person, organization, location hoặc event trong text.
- Theo Practical NLP, NER cũng bao gồm các specialized strings như money expressions, dates, products, names/numbers of laws hoặc articles.
- NER khác Keyphrase Extraction: KPE tìm cụm ý chính của document, còn NER tìm entity spans và entity types.
- Cần xử lý special tokens và subword labels đúng cách.
- Tokenizing Texts for NER là bước nối word-level labels với token/subword IDs, thường dùng
word_ids()và label-100cho vị trí không tính loss. - Performance Measures for NER nên dùng entity-level precision, recall và F1 vì token accuracy dễ bị nhãn
Olàm đẹp giả. - Thường dùng BIO/BILOU tagging scheme.
Ví dụ trực quan
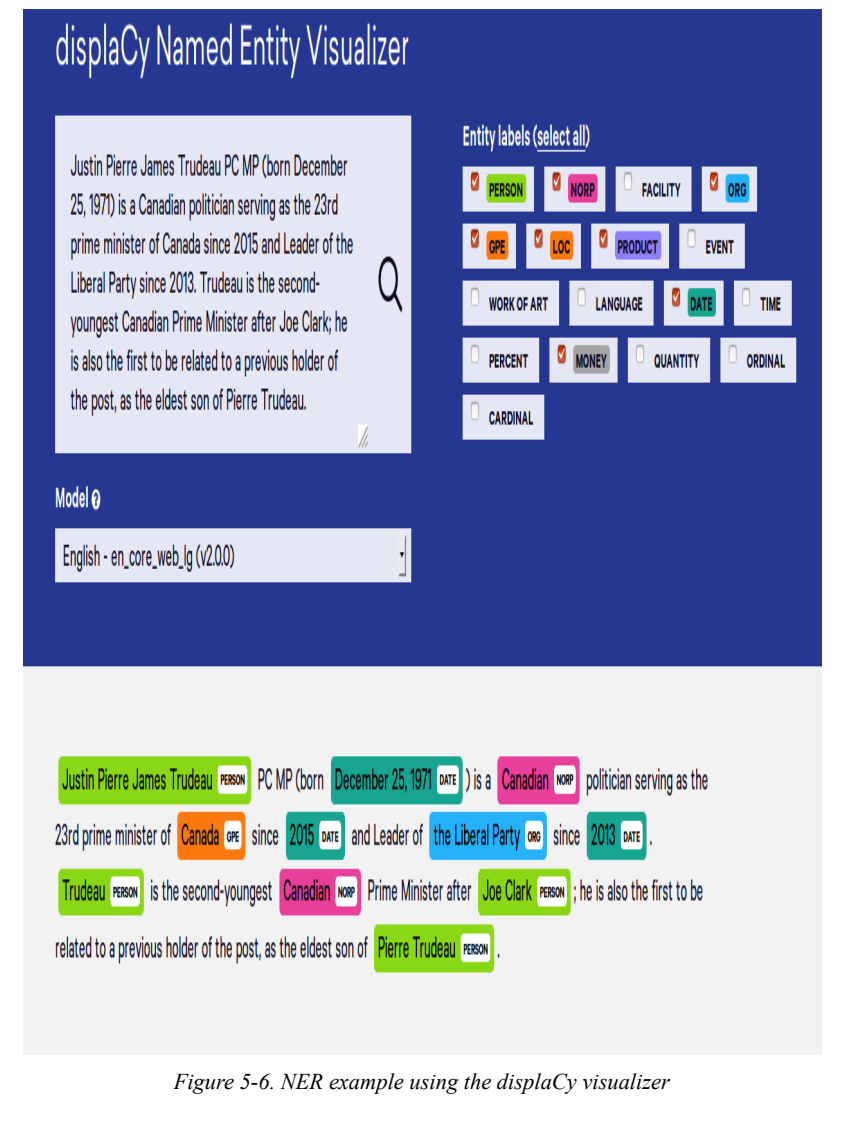
Ý chính: displaCy visualizer cho thấy NER output là các span được gán label như PERSON, DATE, ORG hoặc GPE. Vì vậy NER là bài toán nhận diện “đoạn nào trong text là entity gì”, không phải phân loại cả document.
Nguồn: Practical Natural Language Processing - Figure 5-6.
Trong Information Extraction
- NER là bước quan trọng trong Information Extraction Pipeline vì nhiều task sâu hơn cần biết trước entities nào xuất hiện.
- Relation Extraction cần entity mentions để trích quan hệ giữa chúng.
- Event Extraction cần entities/dates/locations để mô tả sự kiện.
- Trong search, ví dụ query “Where was Albert Einstein born?”, hệ thống cần nhận ra
Albert Einsteinlà person trước khi tìm thuộc tính place of birth. - NER cũng hữu ích cho machine translation vì names không nhất thiết phải dịch nguyên kiểu từ thường.
Cách xây hệ thống
Known names
-> [[Gazetteer]] lookup

Known patterns
-> rule-based NER

Need generalization
-> [[Sequence Labeling]] model- Cách đơn giản nhất là lookup bằng Gazetteer.
- Rule-based NER dùng pattern trên token và POS tags, ví dụ
NNP was born. - Hướng thực tế hơn là train ML model cho unseen text.
- Practical NLP nhấn mạnh NER là bài toán Sequence Labeling: nhãn của current word phụ thuộc vào surrounding context.
- Ví dụ
Washingtonchỉ phân biệt rõ là person hay location khi nhìn cả câu.
Dữ liệu train
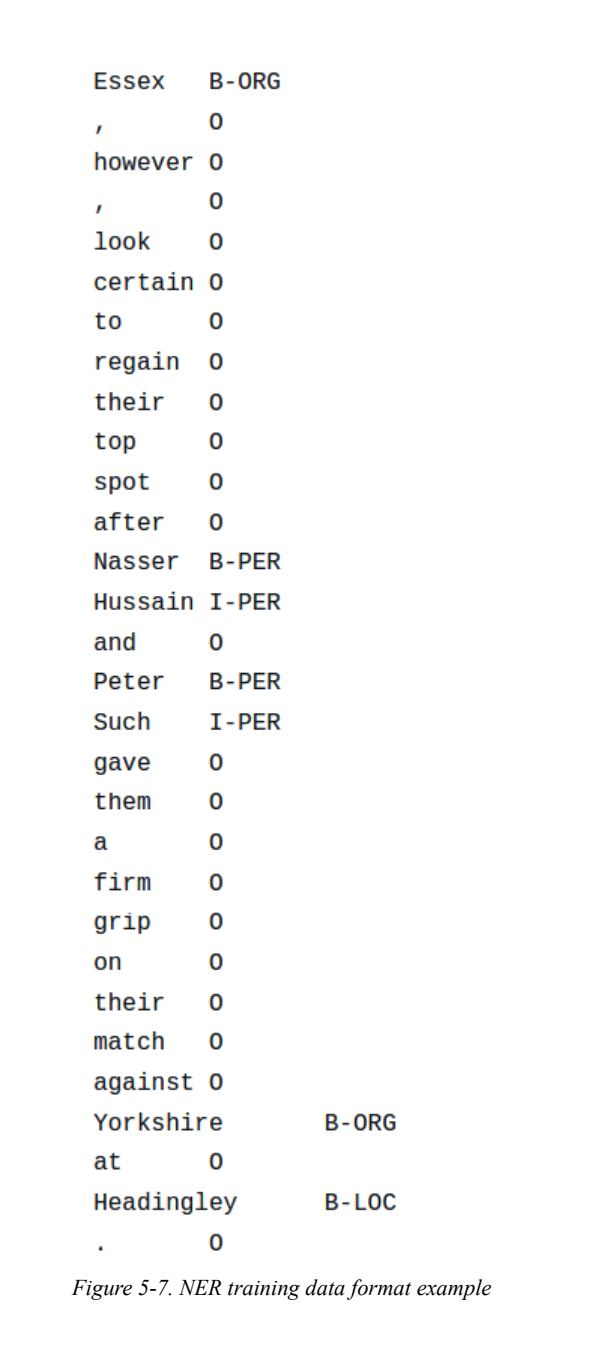
Ý chính: BIO format cho thấy NER training data nằm ở mức token trong từng câu, giúp model học cả span boundary lẫn entity type.
Nguồn: Practical Natural Language Processing - Figure 5-7.
Bđánh dấu beginning of an entity.Iđánh dấu token nằm bên trong entity nhiều từ.Ođánh dấu token không thuộc entity nào.- Ví dụ
PeterlàB-PER,SuchlàI-PER. - Entity một từ như
EssexhoặcHeadingleychỉ cầnB-*.