Keyphrase Extraction
Định nghĩa
Keyphrase extraction là task trích keyword hoặc keyphrase biểu diễn chủ đề, khái niệm hoặc nội dung chính trong một text.
Cách hiểu bằng lời của tôi
Nếu Named Entity Recognition hỏi “trong text có thực thể nào?”, keyphrase extraction hỏi “text này đang nói về những cụm ý chính nào?”.
Trong IE
- Practical NLP dùng ví dụ bài báo về Apple:
buybackhoặcstock pricelà keyphrases nói lên chủ đề của bài. - Đây là một task thuộc Information Extraction và thường cần ít NLP processing hơn các task như relation extraction hoặc event extraction.
- Một số thuật toán keyphrase extraction có thể dùng thêm POS tagging trước khi chọn keyphrases.
Ví dụ trực quan
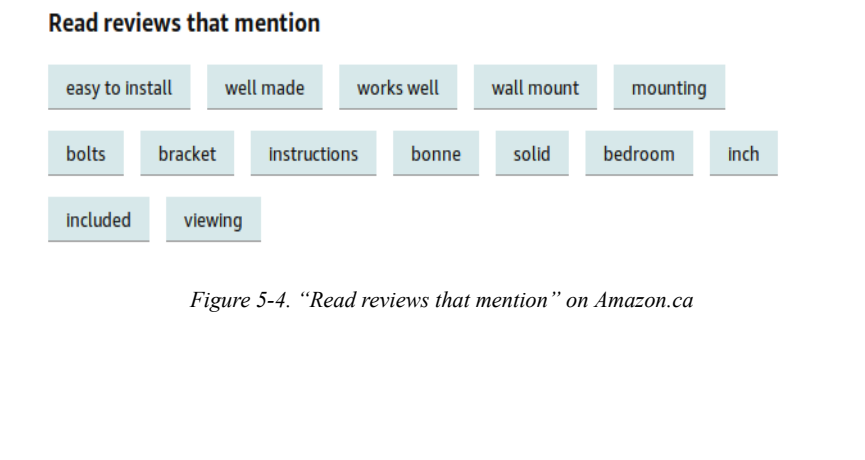
Ý chính: Amazon “Read reviews that mention” là ví dụ KPE trong product: các keyphrases giúp người dùng lọc nhanh hàng trăm review theo những cụm được nhắc nhiều.
Nguồn: Practical Natural Language Processing - Figure 5-4.
Khi nào dùng
- Search hoặc information retrieval.
- Automatic document tagging.
- Recommendation systems.
- Text summarization.
- Product UX cần giúp người dùng scan nhanh nhiều text, ví dụ reviews.
Hướng tiếp cận
- Supervised KPE: cần dataset có text và keyphrases tương ứng; có thể dùng engineered features hoặc deep learning, nhưng labeled data tốn thời gian và chi phí.
- Unsupervised KPE: không cần labeled dataset và thường domain-agnostic hơn, nên phổ biến hơn trong real-world KPE.
Graph-based KPE
Text document
-> candidate words/phrases
-> weighted graph
-> score nodes by frequency + connectivity
-> top-N keyphrases- Các algorithm unsupervised phổ biến biểu diễn words/phrases như nodes trong weighted graph.
- Keyphrase quan trọng là node vừa xuất hiện đủ thường xuyên vừa connected tốt với nhiều phần của text.
- Các approach khác nhau ở cách chọn candidate phrases và cách score graph.
- Sách minh họa implementation bằng
textacytrênspaCyvới TextRank và SGRank.
Quyết định triển khai
Recipe tối thiểu
Raw document
-> load text
-> create spaCy/textacy doc
-> run TextRank or SGRank
-> collect top-N keyphrases + weights
-> inspect output
-> tune preprocessing / candidate filtering / post-processing- Sách minh họa cách dùng
textacy, một thư viện xây trênspaCy, để chạy các graph-based KPE algorithms. - TextRank và SGRank có thể trả output khác nhau trên cùng một document, nên không nên chọn algorithm chỉ vì nó chạy được.
- Output cần được đọc lại theo mục tiêu product: keyphrases có quá dài không, có overlap không, có phrase nhiễu không, có đúng domain không.
Knob cần chỉnh
- Chọn độ dài n-gram cho candidate phrases.
- Chọn POS tags nên giữ hoặc bỏ.
- Quyết định preprocessing trước khi extract.
- Loại overlapping n-grams, ví dụ hai cụm gần trùng nghĩa hoặc một cụm là phần con của cụm khác.
- So sánh nhiều implementation như
textacy,gensim, hoặc TextRank tự implement trước khi chọn.
Caveat production
Graph-based KPE output
-> length control
-> overlap removal
-> bad-pattern filtering
-> text-extraction cleanup
-> domain heuristic layer
-> final keyphrase list- Document length: graph và candidate n-grams nhạy với độ dài document. Nếu document quá dài, có thể không dùng full text mà dùng phần đầu M% và phần cuối N%, vì hai phần này thường chứa summary chính.
- Overlapping keyphrases: top phrases có thể chồng nhau, ví dụ một phrase là phần con của phrase khác. Vì mỗi keyphrase được rank độc lập, cần de-duplicate hoặc dùng similarity measure như cosine similarity để giữ các phrase khác nhau hơn.
- Unwanted patterns: cần rule để loại cụm có pattern không mong muốn, ví dụ bắt đầu bằng preposition.
- Text extraction noise: lỗi extract text từ PDF/scanned images có thể làm KPE nhiễu vì KPE nhạy với sentence structure. Vì vậy output nên đi qua post-processing để thành final meaningful list.
- Domain heuristics: custom solution thực tế thường là graph-based algorithm cộng thêm domain-specific heuristics, ví dụ phrase normalization, blacklist/whitelist pattern hoặc rule loại phrase quá chung.
Mental model triển khai
KPE production không dừng ở bước topn=5. Algorithm chỉ tạo ranking ban đầu; phần làm output dùng được nằm ở việc lọc trùng, lọc nhiễu, xử lý lỗi text extraction và điều chỉnh heuristic theo domain.