Information Extraction Pipeline
Định nghĩa
Information extraction pipeline là chuỗi bước NLP biến raw text thành các đơn vị có cấu trúc hơn như keyphrases, named entities, entity links, relations hoặc events.
Cách hiểu bằng lời của tôi
Pipeline IE giống một thang phân tích. Bước đầu chỉ làm text dễ xử lý hơn; càng về sau, hệ thống càng phải hiểu nhiều cấu trúc ngôn ngữ hơn để trích đúng entity, quan hệ hoặc sự kiện.
Figure
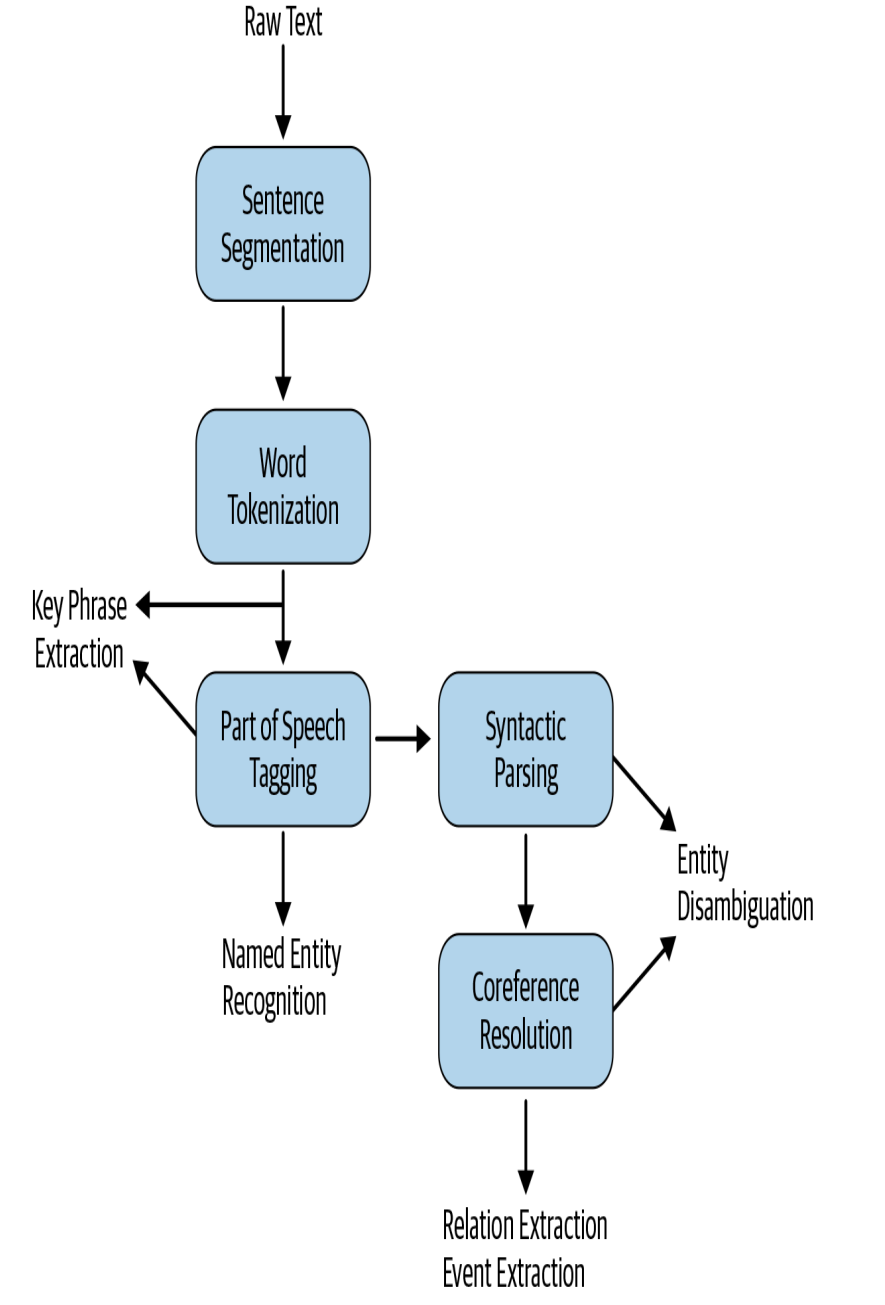
Ý chính: Figure 5-3 cho thấy các task IE cần mức preprocessing khác nhau. KPE có thể rẽ sớm sau tokenization/POS tagging, còn relation extraction và event extraction nằm sau các bước sâu hơn như syntactic parsing và coreference resolution.
Nguồn: Practical Natural Language Processing - Figure 5-3.
Flow
Raw text
-> sentence segmentation
-> word tokenization
-> part-of-speech tagging
-> syntactic parsing / named entity recognition
-> coreference resolution / entity disambiguation
-> relation extraction / event extraction
Cần biết
- IE thường cần fine-grained NLP processing hơn Text Classification vì output không chỉ là một category cho cả document.
- Keyphrase Extraction là task cần ít NLP processing nhất; một số algorithm dùng thêm POS tagging.
- Named Entity Recognition cần nhận diện entity spans và entity types như person hoặc organization.
- Coreference resolution giúp nối nhiều mention về cùng một entity, ví dụ
Albert Einstein,Einstein,the scientist,he. - Relation extraction và event extraction thường cần preprocessing sâu hơn, sau đó mới dùng model riêng cho task.
- Evaluation IE thường dùng precision, recall và F1; kết quả bị ảnh hưởng bởi độ chính xác của các bước preprocessing.