Practical NLP - Chapter 05 - Information Extraction
Mục tiêu cần hiểu
- Information extraction biến text tự do thành thực thể, quan hệ, sự kiện hoặc schema có cấu trúc.
- Named Entity Recognition chỉ là một phần của IE pipeline.
- Entity linking, relationship extraction và template filling mở rộng NER thành dữ liệu dùng được.
Định nghĩa quan trọng
- Information Extraction
- Keyphrase Extraction
- Named Entity Recognition
- Named entity disambiguation
- Entity Linking
- Relation Extraction
- Event Extraction
- Template Filling
- Information Extraction Pipeline
Mental model
Text thô
-> mention / keyphrase
-> entity
-> entity linking
-> relation / event
-> structured record
Phần cần biết
- Giá trị thực tế của IE nằm ở việc biến văn bản thành dữ liệu có thể query, đo lường, hoặc đưa vào workflow.
- Khi đọc, chú ý ranh giới giữa extraction, disambiguation và linking.
- Information Extraction Pipeline thường cần nhiều bước phân tích ngôn ngữ hơn text classification, nhưng không phải task IE nào cũng cần đủ mọi bước.
IE Applications
Vì sao IE cần thiết
Unstructured text
-> extract entities / events / relations / fields
-> structured information
-> search / recommendation / chatbot / workflow- Information Extraction là task trích thông tin liên quan từ text documents.
- Text là unstructured data: khác database/table có schema rõ, free-flowing text không cho biết sẵn thông tin nằm ở trường nào.
- Với thông tin có fixed pattern như address, phone number hoặc date, pattern-based extraction như regular expressions có thể tương đối đơn giản.
- Với thông tin như tên người, quan hệ giữa entities hoặc chi tiết calendar event, cần language processing sâu hơn.
Tagging news and other content
- News và content mỗi ngày chứa nhiều entities/events đang xảy ra.
- Ngoài phân loại article bằng Text Classification, search engines và recommendation systems còn cần tag các entities quan trọng trong text.
- Ví dụ Google News trích people, organizations, locations và events để reader đi trực tiếp tới news về entity cụ thể.
- Đây là IE ở dạng product: không chỉ biết article thuộc topic nào, mà còn biết article nói về ai/cái gì/sự kiện nào.
Chatbots
- Chatbot cần hiểu question trước khi retrieve hoặc generate response.
- Ví dụ câu “What are the best cafes around the Eiffel Tower?” yêu cầu hệ thống nhận ra
Eiffel Towervàcafe, rồi tìm cafes trong vùng liên quan tới Eiffel Tower. - IE giúp tách các pieces of information cụ thể khỏi user query để downstream system dùng được.
Social media
- Social media như Twitter chứa thông tin cập nhật nhanh và nhiều nhiễu.
- IE có thể trích informative excerpts phục vụ decision making, ví dụ traffic updates hoặc disaster relief efforts.
- Ứng dụng này nhấn mạnh yếu tố time-sensitive: thông tin không chỉ đúng, mà còn cần được trích nhanh từ dòng text liên tục.
Forms and receipts
- Banking apps, bill scanning và receipt scanning thường kết hợp OCR với IE.
- OCR đọc chữ từ ảnh; IE trích các field có ý nghĩa như thông tin trên check, bill hoặc receipt.
- Sách không đi sâu hướng này trong chapter vì OCR là bước chính và không thuộc NLP processing pipeline của sách.
IE Tasks
Taxonomy task
Text
-> keyphrase / keyword
-> named entity mention
-> entity disambiguation + linking
-> relation
-> event / temporal information
-> template slots- IE là umbrella term cho nhiều task có độ phức tạp khác nhau. Mục tiêu chung là extract “knowledge” từ text.
- Với ví dụ bài báo New York Times về Apple, các task IE xuất hiện ở nhiều tầng:
- Keyphrase Extraction nhận ra bài nói về
buybackhoặcstock price. - Named Entity Recognition nhận diện
Applelà organization vàLuca Maestrilà person. - Named entity disambiguation and linking phân biệt
Applelà Apple Inc., không phải trái táo hay tổ chức khác. - Relation Extraction trích quan hệ
Luca Maestri -> finance chief of -> Apple. - Event Extraction nhận ra bài nói về một event, ví dụ “Apple buys back stocks”, và link các bài khác nói về cùng event theo thời gian.
- Temporal information extraction trích time/date, hữu ích cho calendar apps và interactive personal assistants.
- Template Filling điền các slot trong template chuẩn từ dữ liệu đã extract, ví dụ weather report hoặc flight announcement.
Độ khó và cách triển khai
- Các task IE cần mức NLP processing khác nhau.
- KPE cần ít NLP processing nhất; một số thuật toán có thể dùng thêm POS tagging.
- NER là task được nghiên cứu nhiều và có nhiều giải pháp đã thử nghiệm.
- Các task như entity linking, relation extraction, event extraction và template filling thường khó hơn, cần preprocessing sâu hơn và model riêng cho task.
- Vì IE phụ thuộc domain mạnh, ví dụ finance, news, airlines, hệ thống IE trong industry thường là hybrid: rule-based + learning-based.
- Không phải task IE nào cũng “solved” đủ để có standard approach tốt cho production. Với task khó, sách nhắc việc dùng pay-as-you-use services từ các provider lớn như Microsoft, Google và IBM.
- Dataset cho IE thường chuyên biệt hơn text classification. Thay vì chỉ cần text → category, IE cần annotation mịn hơn như span, entity identity, relation hoặc slot.
- IE thường đánh giá bằng precision, recall và F1 trên standard evaluation sets. Kết quả cũng phụ thuộc vào độ chính xác của các bước preprocessing trước đó.
The General Pipeline for IE
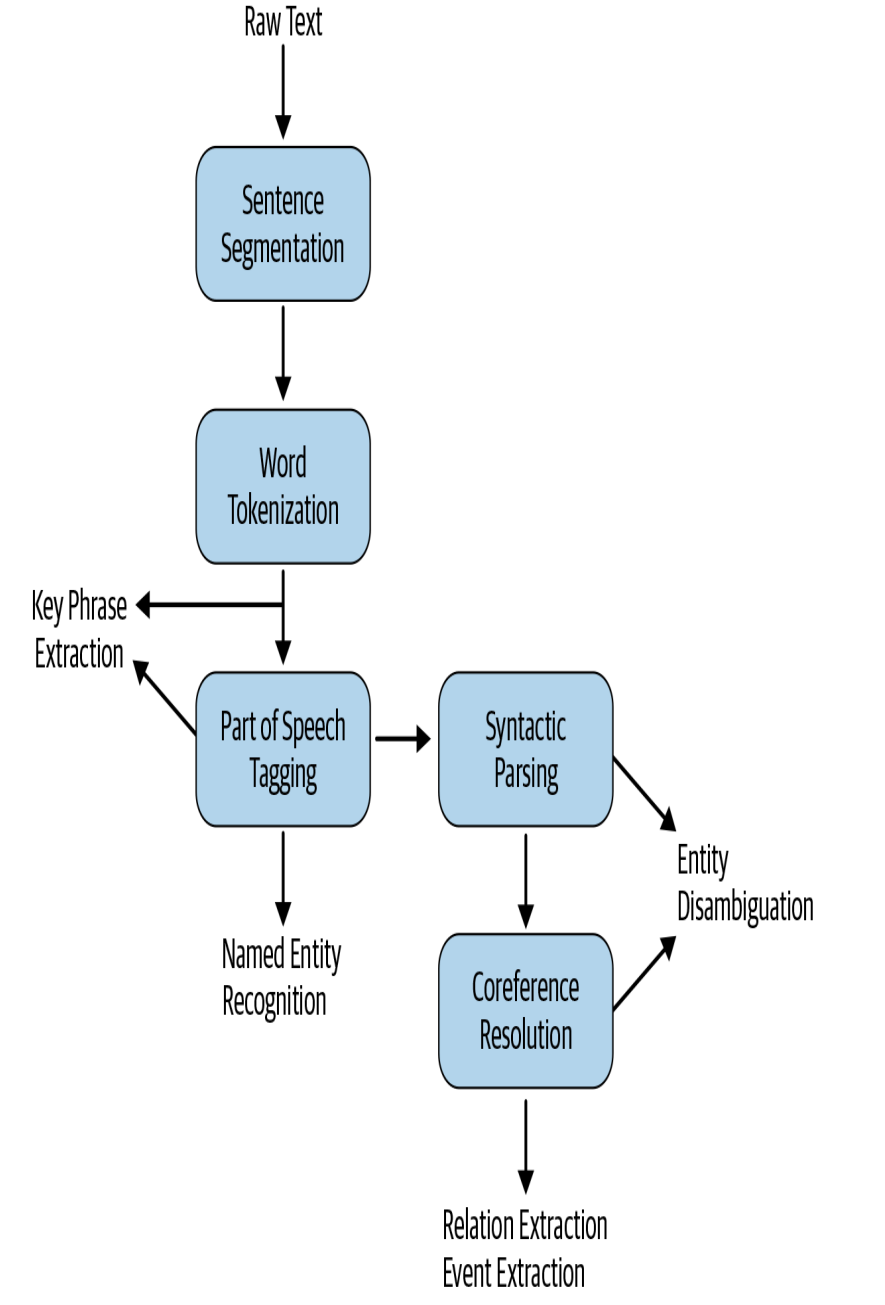
Ý chính: Figure 5-3 cho thấy IE không phải một model đơn lẻ. Nó là chuỗi phân tích từ text thô tới các representation ngày càng giàu cấu trúc hơn.
Nguồn: Practical Natural Language Processing - Figure 5-3.
Raw text
-> sentence segmentation
-> word tokenization
-> part-of-speech tagging
-> named entity recognition / syntactic parsing
-> coreference resolution / entity disambiguation
-> relation extraction / event extraction- So với Text Classification, IE cần fine-grained NLP processing hơn vì nhiều output nằm ở mức token/span/entity/relation thay vì label cấp document.
- Để nhận diện named entities như person hoặc organization, hệ thống có thể cần biết part-of-speech tags của words.
- Để liên kết nhiều reference về cùng một entity, ví dụ
Albert Einstein,Einstein,the scientist,he, hệ thống cần coreference resolution. - Các bước như POS tagging và coreference resolution không bắt buộc trong text classification, nhưng có thể rất quan trọng trong IE.
- Không phải mọi task IE đều cần toàn bộ pipeline. Keyphrase Extraction cần ít processing nhất; một số algorithm thêm POS tagging trước khi chọn keyphrases.
- Ngoài Named Entity Recognition, các task IE còn lại thường cần preprocessing sâu hơn và model riêng cho từng task.
- Vì task IE phụ thuộc vào độ chính xác của preprocessing, khi tự thu thập data và train model IE cần tính cả lỗi lan truyền từ các bước trước.
Keyphrase Extraction
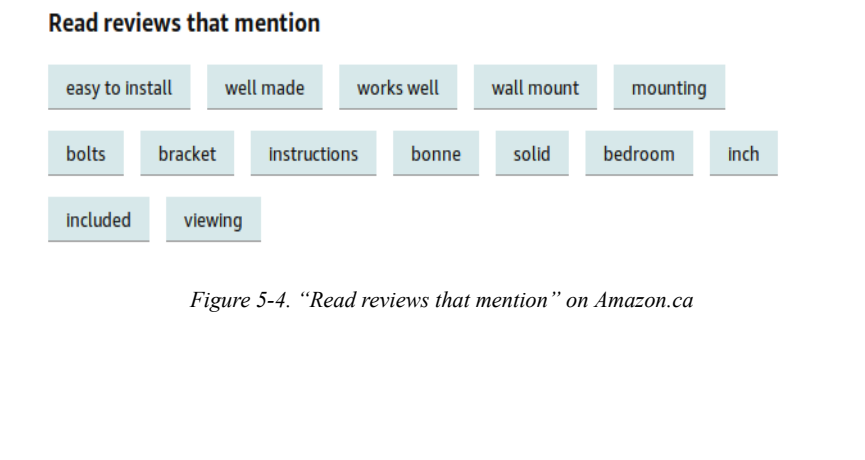
Ý chính: Figure 5-4 minh họa KPE trong product: thay vì đọc toàn bộ review, người dùng chọn các phrase được nhắc nhiều để lọc nhanh nội dung liên quan.
Nguồn: Practical Natural Language Processing - Figure 5-4.
KPE là gì
- Keyword and phrase extraction là IE task trích các words/phrases quan trọng để nắm gist của document.
- KPE hữu ích cho search/information retrieval, automatic document tagging, recommendation systems và text summarization.
- KPE khác Named Entity Recognition ở mục tiêu: KPE tìm cụm ý chính của document, không nhất thiết tìm named entities.
Hướng tiếp cận
- Hai hướng phổ biến là supervised learning và unsupervised learning.
- Supervised KPE cần corpora gồm text và keyphrases tương ứng; có thể dùng engineered features hoặc deep learning, nhưng tạo labeled dataset tốn thời gian và chi phí.
- Unsupervised KPE không cần labeled dataset, thường domain-agnostic hơn, nên phổ biến hơn trong ứng dụng thực tế.
- Sách ghi nhận research gần đây cho thấy state-of-the-art DL methods cho KPE không nhất thiết tốt hơn unsupervised approaches.
Graph-based KPE
Document
-> candidate words/phrases
-> weighted graph
-> score nodes by importance/connectivity
-> top-N keyphrases- Các unsupervised KPE algorithm phổ biến biểu diễn words/phrases như nodes trong weighted graph.
- Weight biểu diễn mức quan trọng của keyphrase.
- Keyphrase được chọn dựa trên mức connected với phần còn lại của graph.
- Node quan trọng thường vừa đủ frequent vừa liên kết tốt với nhiều phần khác của text.
- Các graph-based approach khác nhau ở cách chọn candidate words/phrases và cách score graph.
Implementing KPE
- Sách minh họa dùng
textacytrênspaCyvới hai thuật toán TextRank và SGRank. - Recipe triển khai trong sách:
Raw document
-> load text
-> create spaCy language pipeline
-> convert text into textacy/spaCy doc
-> run TextRank or SGRank
-> return top-N keyphrases with scores/weights
-> inspect and tune output- TextRank và SGRank đều là graph-based keyword/keyphrase extraction algorithms, nhưng output có thể khác nhau đáng kể trên cùng một text.
- Ví dụ trong sách, TextRank trả nhiều cụm dài xoay quanh
natural language processing, còn SGRank trả cả cụm nhưstatistical machine translation,research,late 1980. - Các quyết định triển khai cần chỉnh gồm độ dài n-gram, POS tags nên giữ/bỏ, preprocessing trước khi extract, và cách loại overlapping n-grams.
- Có thể thử nhiều implementation, ví dụ
textacy,gensim, hoặc tự implement TextRank, rồi so sánh trước khi chọn. - Với KPE, việc “implement” nên hiểu là tạo một loop thử nghiệm: chạy algorithm sẵn có, đọc output, chỉnh candidate selection/scoring/post-processing, rồi so sánh với nhu cầu của product.
Practical advice
Practical advice của sách có thể hiểu như checklist debug KPE trong production:
Raw text
-> choose useful text region
-> extract candidate n-grams
-> build graph + rank
-> remove overlap / bad patterns / extraction noise
-> add domain heuristics
-> final meaningful keyphrase list- Document length: tạo candidate n-grams và graph nhạy với độ dài document. Một cách xử lý là không dùng toàn bộ text, mà dùng phần đầu M% và phần cuối N% vì introduction/conclusion thường chứa summary chính.
- Overlapping keyphrases: có thể xuất hiện các cụm chồng nhau như
buy back stockvàbuy back. Vì mỗi keyphrase được rank độc lập, top-N có thể lặp ý. Có thể dùng similarity measure như cosine similarity giữa top-ranked keyphrases để giữ các cụm dissimilar hơn. - Unwanted patterns: đôi khi keyphrase có pattern không mong muốn, ví dụ bắt đầu bằng preposition. Có thể chỉnh implementation hoặc encode rule/heuristic để loại pattern này.
- Text extraction errors: với PDF hoặc scanned images, lỗi extract text ảnh hưởng mạnh tới KPE vì KPE nhạy với sentence structure. Nên có post-processing để tạo final meaningful list ít noise.
- Domain heuristics: custom KPE thực tế có thể kết hợp graph-based algorithm sẵn có với list heuristic theo domain, ví dụ whitelist/blacklist pattern, phrase normalization hoặc rule loại phrase quá chung.
- Bài học chính: graph-based KPE là điểm bắt đầu tốt, nhưng production KPE cần vòng cleanup và tuning riêng cho dữ liệu thật.
Named Entity Recognition
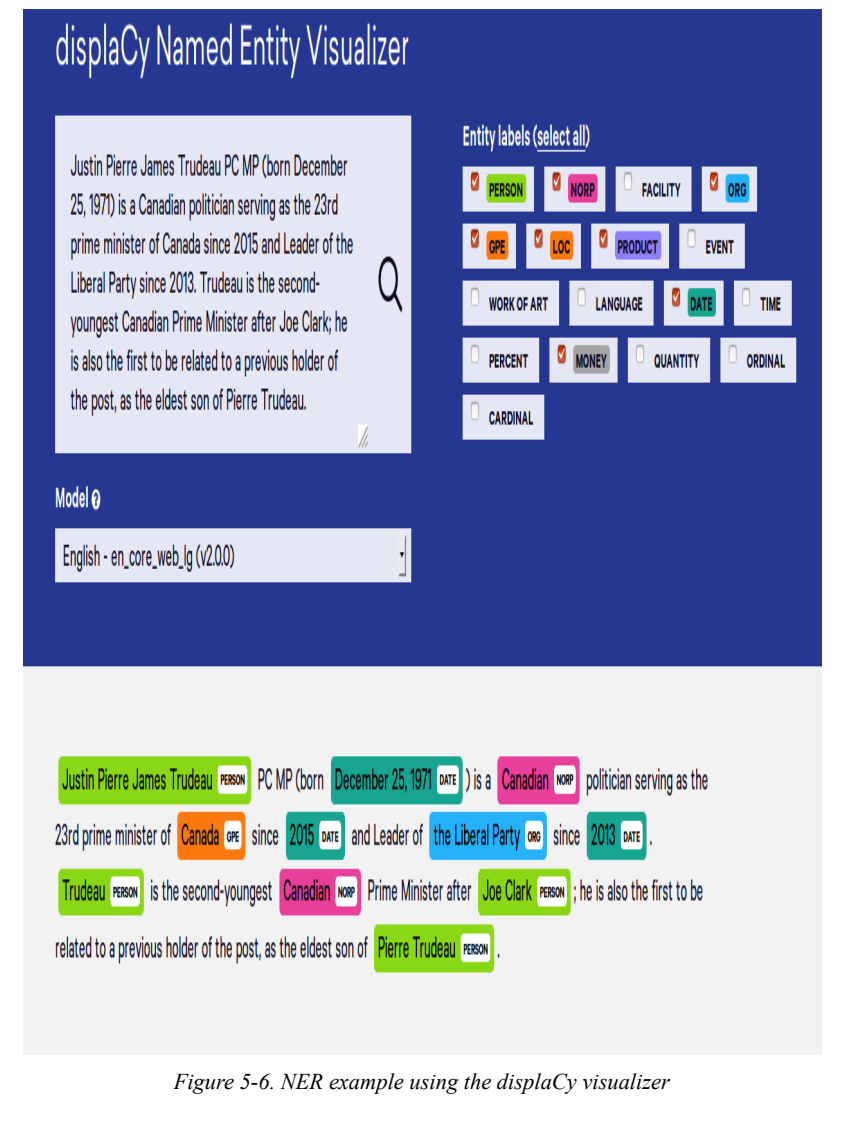
Ý chính: Figure 5-6 minh họa NER bằng displaCy: text được tô các span và gán label như PERSON, ORG, DATE, GPE/NORP. Đây là output ở mức span/entity, không phải label cho toàn bộ document.
Nguồn: Practical Natural Language Processing - Figure 5-6.
NER là gì
- Named Entity Recognition là IE task nhận diện entities trong document.
- Entities thường là person, location, organization, và các specialized strings như money expressions, dates, products, names/numbers of laws hoặc articles.
- KPE có thể bắt được tên entity nếu phrase đó quan trọng, nhưng KPE không được thiết kế riêng để tìm named entities. NER thì nhắm trực tiếp vào việc tìm entity mentions và entity types.
Ví dụ search
- Query “Where was Albert Einstein born?” cần hệ thống nhận ra
Albert Einsteinlà person trước khi tìm place of birth. - Output như
Ulm, Germanytrong search result là ví dụ NER nằm trong một workflow lớn hơn: hiểu entity trong query, rồi dùng entity đó để tìm thuộc tính liên quan.
Vai trò trong IE pipeline
- NER là một bước quan trọng trong nhiều NLP applications có Information Extraction.
- NER thường là prerequisite cho các IE task sâu hơn như Relation Extraction và Event Extraction, vì các task này cần biết entities nào đang xuất hiện trước khi trích relation/event.
- NER cũng hữu ích trong machine translation vì names không nhất thiết phải dịch khi dịch câu.
- Sách nhấn mạnh NER là một trong những task NLP thường gặp trong industry.
Building an NER System
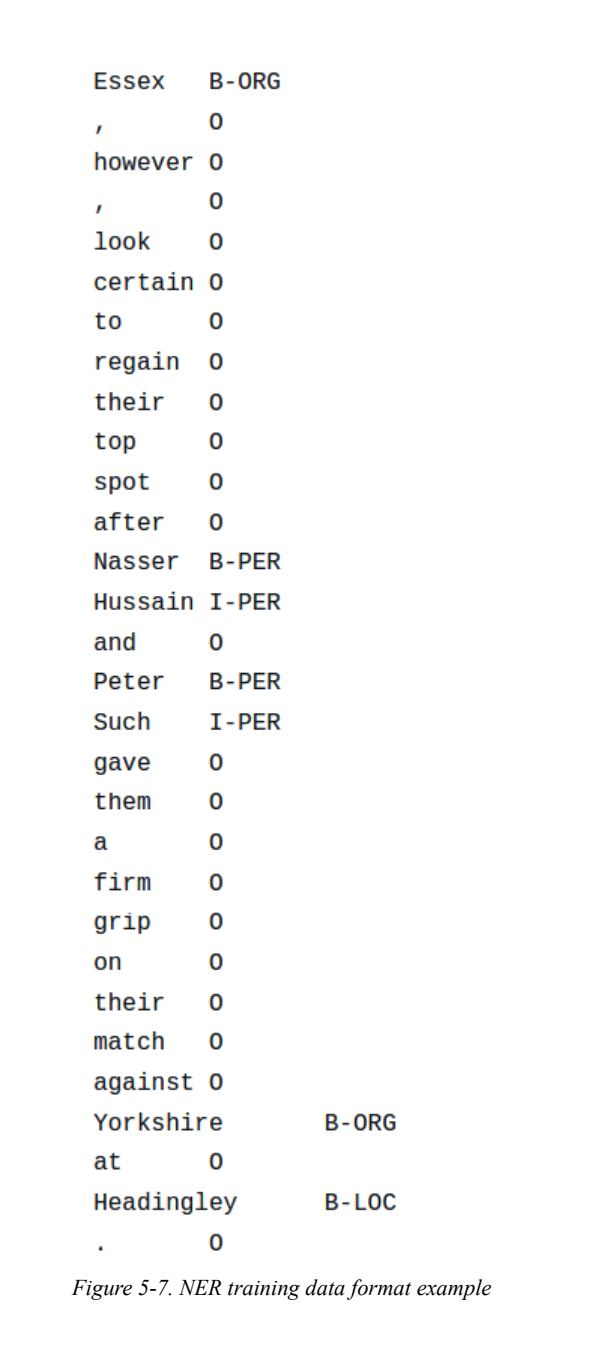
Ý chính: Figure 5-7 cho thấy dữ liệu train NER thường ở mức token với nhãn BIO. Đây là dấu hiệu rõ nhất rằng NER không phải document classification mà là sequence labeling.
Nguồn: Practical Natural Language Processing - Figure 5-7.
Ba cách tiếp cận
Known names only
-> Gazetteer lookup

Known linguistic patterns
-> Rule-based NER

Need generalization to unseen text
-> ML sequence labeling- Cách đơn giản nhất là dùng Gazetteer: một collection lớn các person/organization/location names liên quan tới domain hoặc công ty của mình.
- Nếu phần lớn entities trong dữ liệu được phủ bởi gazetteer, đây là điểm khởi đầu tốt khi chưa có NER system sẵn.
- Nhưng gazetteer tạo ra các câu hỏi thực tế: làm sao xử lý tên mới, update database định kỳ, và theo dõi alias như
USAvớiUnited States. - Bước tiếp theo là rule-based NER: viết pattern dựa trên word tokens và POS tags.
- Ví dụ pattern
NNP was borncó thể gợi ý token mang POSNNPlà person. - Sách nhắc hai công cụ rule-based là Stanford NLP
RegexNERvà spaCyEntityRuler.
ML-based NER và sequence labeling
- Hướng thực tế hơn là train ML model để dự đoán named entities trên unseen text.
- Với mỗi word, hệ thống phải quyết định có phải entity không, và nếu có thì là loại nào.
- Về mặt trực giác, nó giống classification ở Chapter 04, nhưng khác ở chỗ NER là Sequence Labeling.
- Text classifier thường dự đoán label cho mỗi text độc lập với context xung quanh; còn sequence classifier dùng surrounding context để dự đoán current word.
- Ví dụ
Washingtonkhông thể quyết định là person hay location nếu nhìn riêng lẻ; trong câu “Washington is a rainy state”, context mới cho thấy đây là location. - Vì lý do đó, NER thường được model như sequence classification problem.
- Sách nhắc CRF là một training algorithm phổ biến cho sequence classifier trong NER.
- Notebook minh họa dùng dataset CONLL-03 và
sklearn-crfsuitecùng các feature dựa trên word và POS tags.
Dữ liệu train NER
- Để làm sequence classification, dữ liệu phải giữ được context ở mức sentence.
- Practical NLP dùng Figure 5-7 để minh họa format annotation trong CONLL-03.
- BIO notation:
B= beginning of an entityI= inside an entity nhiều từO= non-entity - Ví dụ
PeterlàB-PER,SuchlàI-PERvì cùng thuộc một person name có hai từ. - Entity một từ như
Essex,Yorkshire,Headingleychỉ cần tagB-ORGhoặcB-LOC.
Quy trình train
Load dataset
-> Extract features
-> Train classifier
-> Evaluate on test set- Sách nhấn mạnh các bước train NER ở mức cao vẫn giống pipeline text classifiers ở Chapter 04.
- Điểm khác biệt cốt lõi nằm ở loại dữ liệu, feature ngữ cảnh, và việc dùng sequence classifier thay vì classifier độc lập từng sample.
Named Entity Disambiguation and Linking
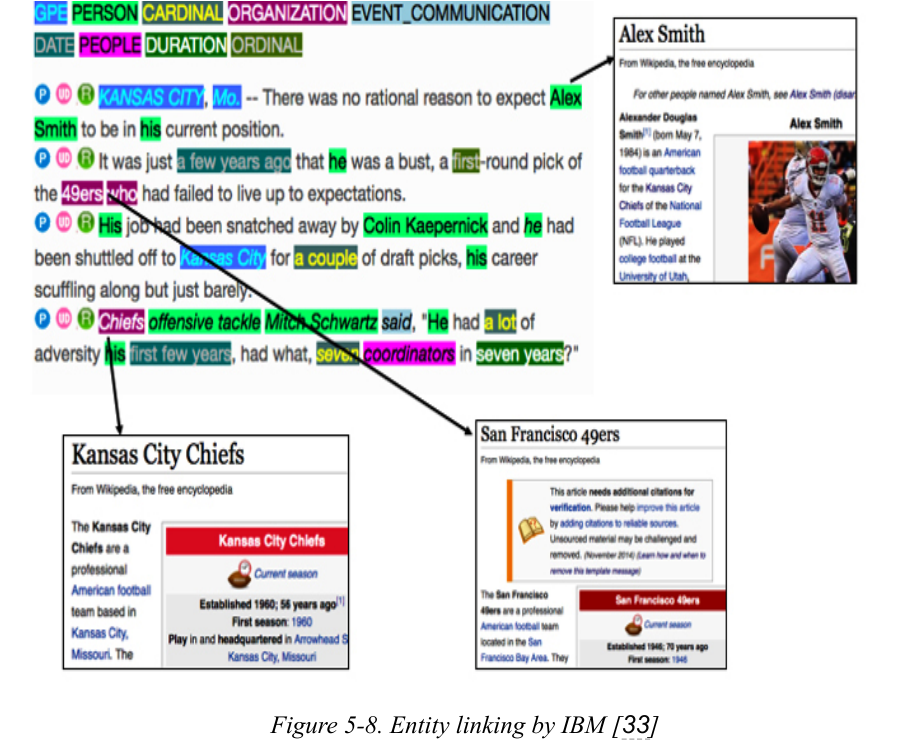
Ý chính: Figure 5-8 minh họa entity linking như một bước nối entity mention trong bài báo với entity thật trong thế giới/knowledge base. Output này giàu hơn NER vì nó không chỉ nói type, mà còn nói identity.
Nguồn: Practical Natural Language Processing - Figure 5-8.
Bài toán là gì
entity mention trong text
-> dùng context để phân biệt nghĩa
-> gán unique identity trong knowledge base- Named entity disambiguation (NED) là task gán một identity duy nhất cho entity được nhắc trong text.
- Named Entity Recognition + NED thường được gọi là named entity linking (NEL).
- Ví dụ
Lincoln drives a Lincoln Aviator and lives on Lincoln Way: ba mentionLincolnkhông cùng một thực thể; chúng có thể là person, vehicle và location. - NEL là bước chuyển từ “có entity trong text” sang “entity này là thực thể cụ thể nào”, nên hữu ích cho Question Answering, xây knowledge base/knowledge graph và các task IE sâu hơn.
Khác NER ở đâu
- NER trả lời: span nào là entity và entity type là gì?
- NED/NEL trả lời: entity mention đó trỏ tới thực thể cụ thể nào trong world/knowledge base?
- Vì vậy output của NEL có thể là link tới Wikipedia/DBpedia hoặc ID nội bộ trong knowledge base.
- Khi NEL thành công, thông tin sau đó dùng được cho Relation Extraction vì hệ thống biết đang nối đúng các entity cụ thể, không chỉ nối các chuỗi chữ.
Yêu cầu pipeline
NER output
-> parsing / linguistic context
-> coreference resolution nếu cần
-> candidate entities trong KB
-> disambiguation
-> linked entity- NEL vẫn dựa vào context như NER, nhưng thường cần preprocessing sâu hơn POS tagging.
- Tối thiểu, hệ thống có thể cần parsing để nhận diện các item ngôn ngữ như subject, verb và object.
- Coreference resolution giúp gom nhiều cách nhắc cùng một entity, ví dụ
Albert Einstein,Einstein,the scientist. - NEL thường được model như supervised ML problem và đánh giá bằng precision, recall, F1 trên test set chuẩn.
- Để train NEL cần annotated dataset lớn và một encyclopedic resource/knowledge base để link vào.
Cách triển khai thực tế
- Sách nêu Azure Text Analytics API và DBpedia Spotlight như ví dụ công cụ dùng cho entity linking.
- API có thể trả entity type kèm link Wikipedia nếu tìm được, ví dụ
San Franciscotrỏ tới location cụ thể hoặcAlex Jonestrỏ tới một person cụ thể. - Với industry, sách ghi nhận việc dùng off-the-shelf, pay-as-you-use NEL services thường phổ biến hơn tự xây system in-house vì NEL chuyên biệt và cần tài nguyên lớn.
Giới hạn và trade-off
- NEL system không hoàn hảo, nhất là với tên mới hoặc domain-specific terms.
- Vì NEL phụ thuộc parsing, coreference và text cleanup, lỗi ở các bước trước sẽ lan sang output entity linking.
- Khi dùng third-party services, mình ít kiểm soát cách hệ thống thích nghi với domain hoặc cách sửa internal behavior.
- Bài học triển khai: dùng NEL khi downstream workflow thật sự cần identity cụ thể; nếu chỉ cần tag type/entity span, NER có thể đủ nhẹ hơn.
Relationship Extraction
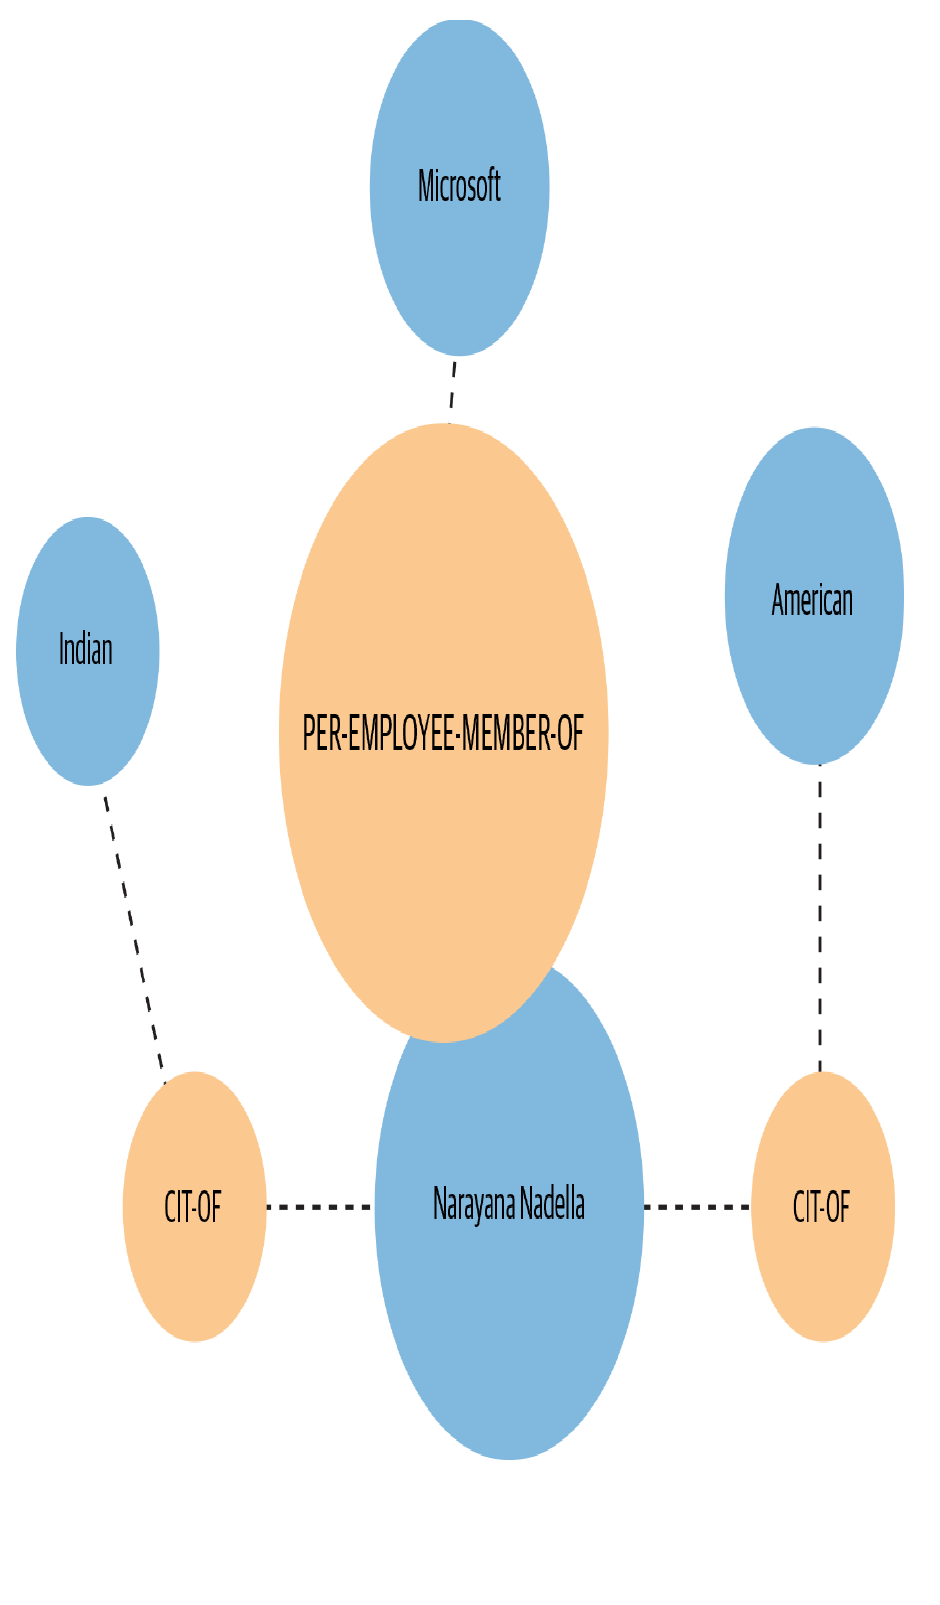
Ý chính: Figure 5-10 minh họa RE như graph: entities là nodes, relation labels là cạnh nối giữa nodes. Đây là bước biến entity rời rạc thành knowledge base có cấu trúc.
Nguồn: Practical Natural Language Processing - Figure 5-10.
RE là gì
entity 1 + entity 2 + context
-> hai entity có liên quan không?
-> nếu có, relation label là gì?- Relationship extraction là IE task trích entities và quan hệ giữa chúng từ text documents.
- RE là bước quan trọng để xây knowledge base, cải thiện search và phát triển Question Answering systems.
- Ví dụ từ bài Apple:
(Luca Maestri, finance chief, Apple)nối person với organization bằng quan hệfinance chief. - Ví dụ Figure 5-10:
Narayana Nadellacó relation vớiMicrosoftnhư employee/member, và relation citizenship vớiIndian,American.
Vì sao khó hơn NER/NEL
- KPE, NER và NEL giúp tìm keyphrases/entities/identity, nhưng RE phải đi thêm bước “connect” các entity bằng relation.
- RE cần xét words nằm giữa entities, sense của cách dùng trong câu, và đôi khi cả syntactic structure.
- Câu hỏi “relation là gì?” phụ thuộc domain. Medical domain có thể cần injury/treatment/location/cause; financial domain có schema relation khác.
- Vì relation schema phụ thuộc domain, một model hoặc pattern chung có thể không đủ cho production.
Approaches to RE
Handwritten patterns
-> supervised classification
-> bootstrapping / distant supervision
-> open IE- Hand-built patterns dùng regular expressions hoặc pattern ngôn ngữ để bắt relation cụ thể.
- Ví dụ pattern
PER, [something] of ORGcó thể gợi ý relation kiểu “is-a-part-of” giữa person và organization. - Pattern-based RE thường có precision cao khi pattern đúng, nhưng coverage thấp và khó tạo đủ pattern cho mọi relation trong domain.
- Supervised RE thường dùng dataset có pre-defined relations, tương tự Text Classification nhưng ở mức entity pair.
- Sách mô tả supervised RE như bài toán 2 bước:
- Hai entities trong text có liên quan không? Đây là binary classification.
- Nếu có liên quan, relation giữa chúng là gì? Đây là multiclass classification.
- Feature có thể gồm handcrafted features, context quanh entity như trong NER, syntactic structure như
NP VP NP, hoặc embedding representations + neural network architecture. - Bootstrapping bắt đầu từ seed patterns nhỏ, rồi học thêm pattern mới từ các sentence được trích.
- Distant Supervision dùng database lớn như Wikipedia hoặc Freebase để tạo nhiều examples relation, sau đó train supervised model.
- Weak Supervision hữu ích khi không có training data rõ ràng, ví dụ dùng Snorkel để học relation cụ thể từ labeling functions/rules.
Open IE
sentence
-> extract relation tuples
-> <verb, argument1, argument2, ...>- Unsupervised RE, còn gọi là open IE, cố gắng trích relation mà không cần training data hoặc danh sách relation có sẵn.
- Output thường là tuple theo động từ và arguments, ví dụ
<published, Albert Einstein, the theory of relativity, in 1915>. - Điểm mạnh: có thể bắt nhiều relation mở mà không cần schema định trước.
- Điểm khó: muốn đưa vào database chuẩn thì phải map output mở về relation set chuẩn như
fatherOf,motherOf,inventorOf. - Nếu cần relation cụ thể từ open IE output, thường phải kết hợp NER/NEL, coreference resolution và procedure riêng để chuẩn hóa.
Dịch vụ có sẵn và trade-off
- Sách nêu IBM Watson Natural Language Understanding như ví dụ service trích relation giữa entities.
- Watson dùng supervised model với preset list of relations, nên relation ngoài danh sách đó sẽ không được extract.
- RE chưa phải solved problem; performance phụ thuộc domain và text type.
- Output tốt trên Wikipedia article không đảm bảo tốt trên general news hoặc social media text.
- Practical advice của sách: bắt đầu bằng pattern-based approaches và dùng một dạng weak supervision khi pretrained supervised models không hợp domain.
Other Advanced IE Tasks
- Sách chuyển sang ba task chuyên biệt hơn: temporal IE, event extraction và template filling.
- Các task này ít gặp hơn trong industry so với KPE, NER, NEL hay RE, nhưng rất hữu ích khi domain có pattern nghiệp vụ rõ.
Temporal Information Extraction
Ý chính: Temporal IE không chỉ trích 3 p.m., today, Friday, mà còn chuẩn hóa chúng sang thời điểm có thể dùng trong calendar hoặc assistant.
Nguồn: Practical Natural Language Processing - Figure 5-14.
- Temporal IE gồm hai phần: extract temporal expression và normalize nó về standard date-time form.
- Extraction có thể làm bằng regex hoặc supervised sequence labeling như NER.
- Normalization khó hơn vì phải map biểu thức tương đối theo ngữ cảnh.
- Sách nhắc Duckling như một off-the-shelf package hữu ích để bắt đầu, cùng với SUTime, Natty, Parsedatetime và Chronic.
Event Extraction
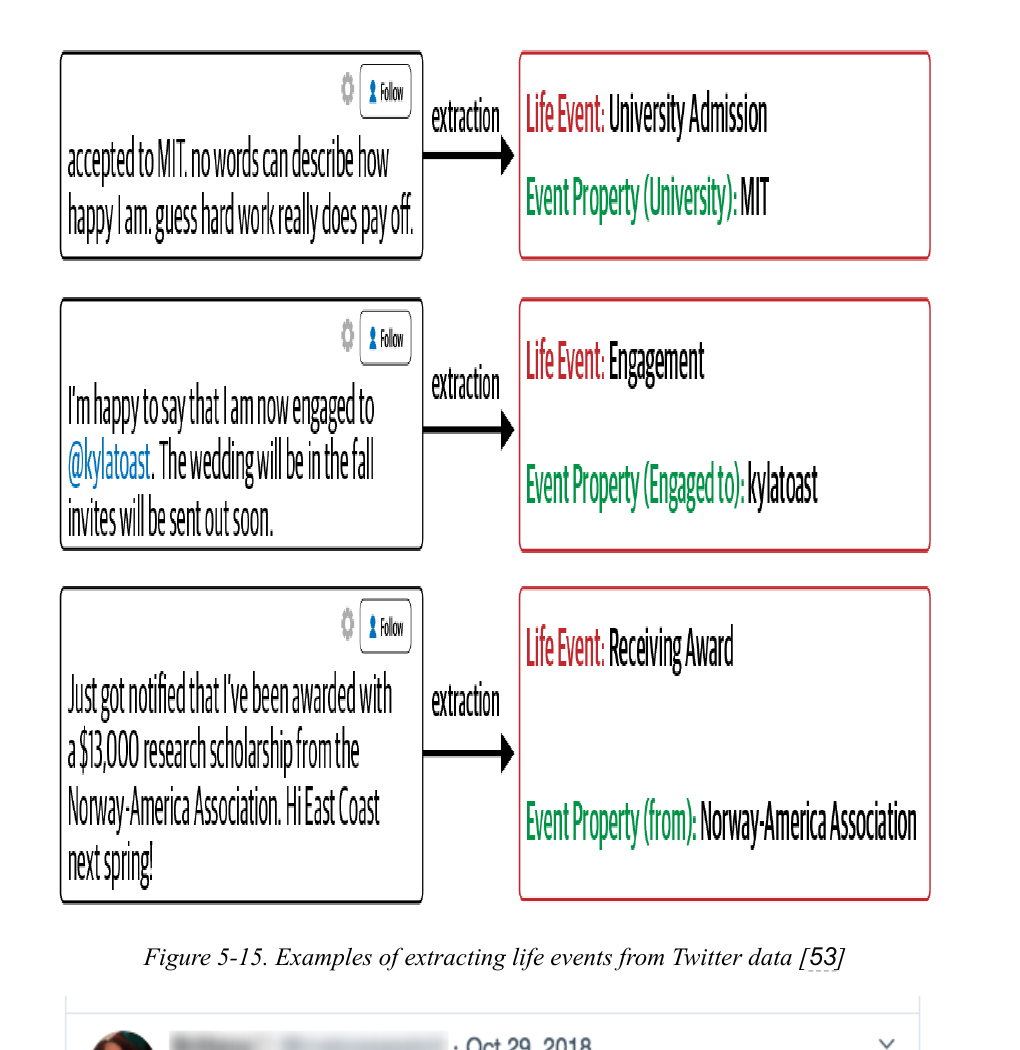
Ý chính: Event extraction cố gắng hiểu “chuyện gì đang xảy ra” và có thể nối nhiều bài viết/tweet về cùng event.
Nguồn: Practical Natural Language Processing - Figure 5-15.
- Event extraction nhận diện event và các thông tin liên quan đến event đó.
- Mục tiêu cuối là tạo temporally ordered event graph.
- Sách mô tả task này như supervised learning problem, với sequence tagging và multilevel classifiers.
- Đây vẫn là active research area và sách không biết có off-the-shelf service hoặc package generic cho task này.
- Practical advice của sách: bắt đầu bằng rule-based approach dựa trên domain knowledge, rồi follow up bằng Weak Supervision; khi có thêm data thì chuyển dần sang ML.
Template Filling
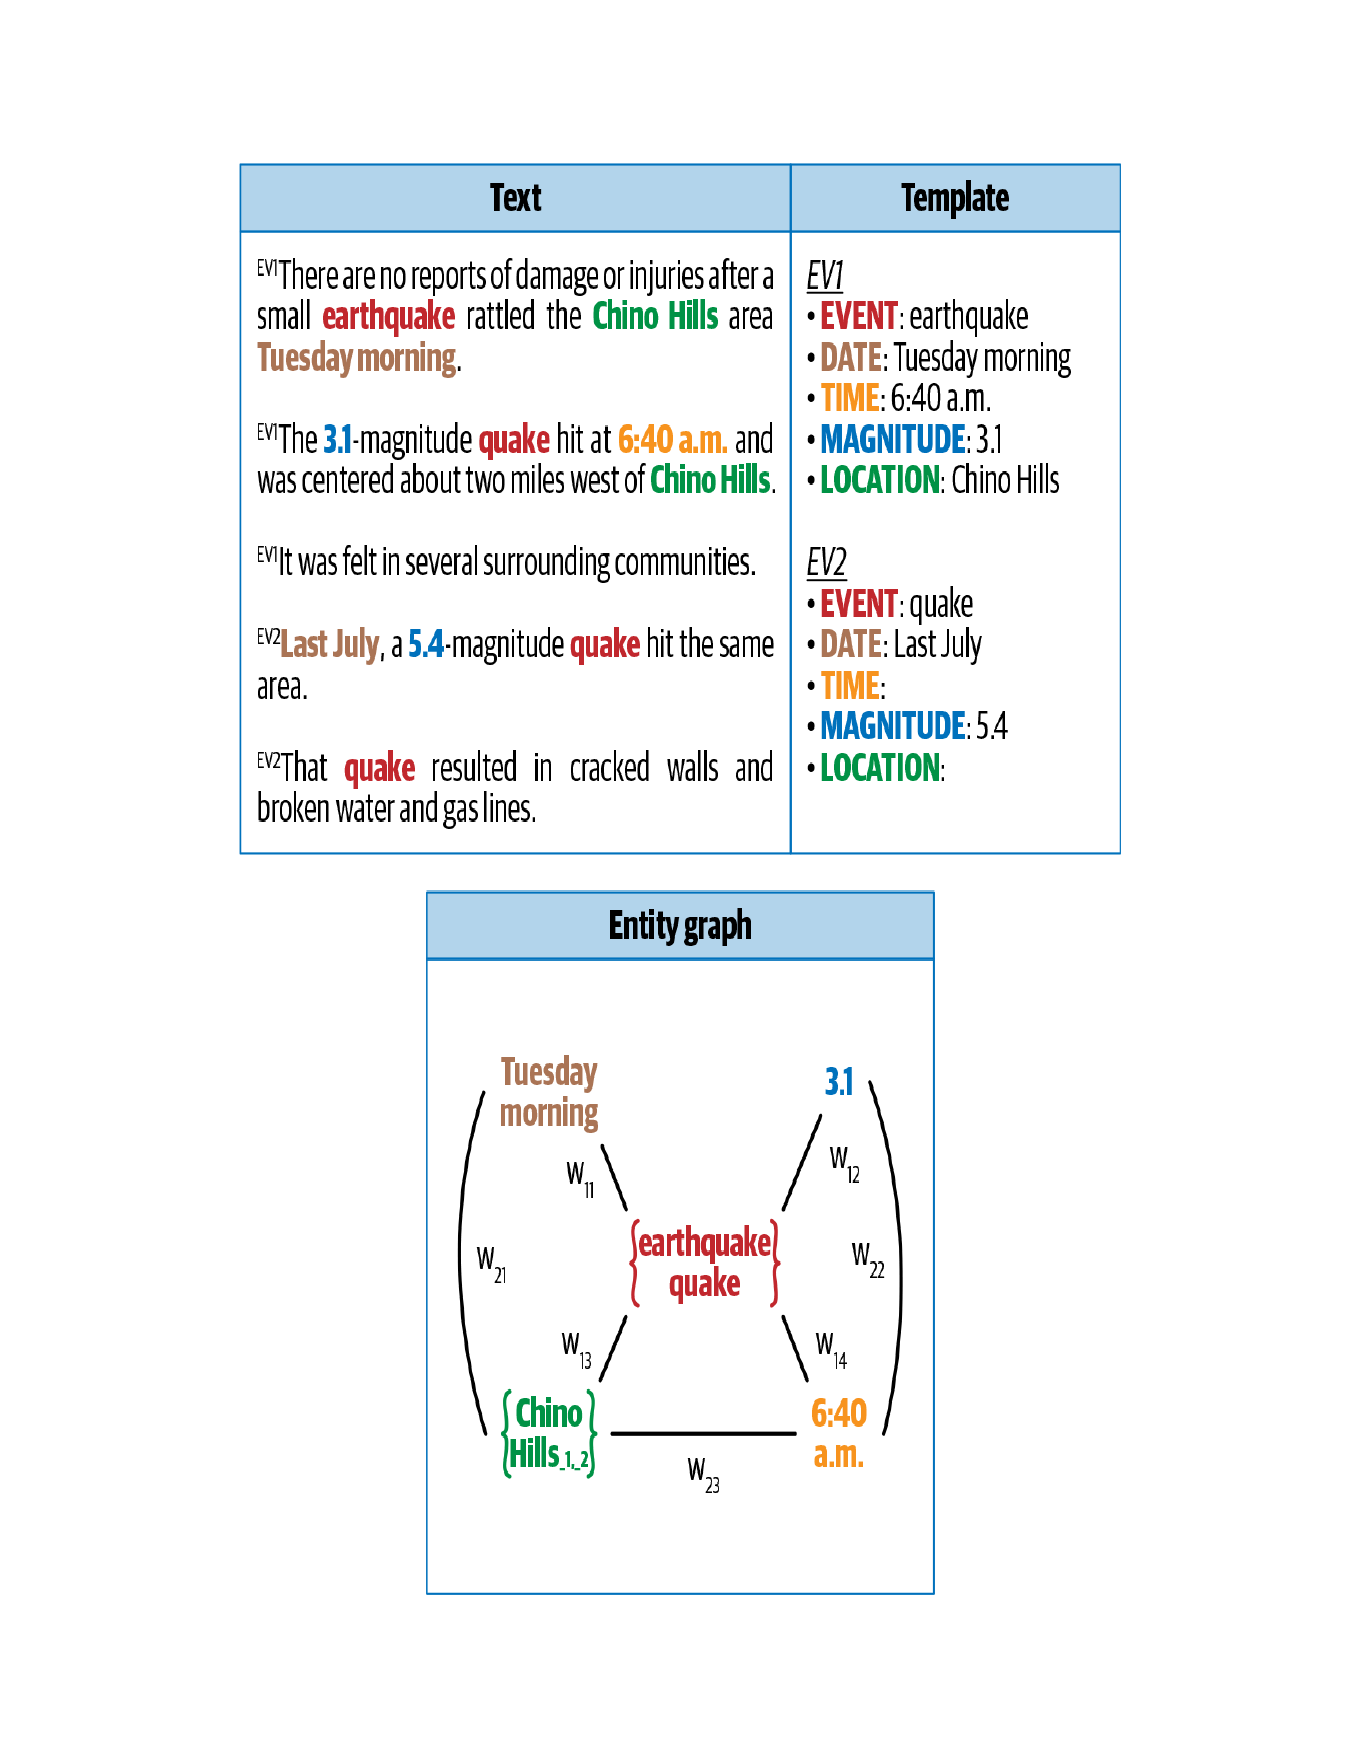
Ý chính: Template filling coi text generation như slot filling: schema đã biết trước, model chỉ cần điền đúng các ô.
Nguồn: Practical Natural Language Processing - Figure 5-17.
- Template filling phù hợp với weather reports, financial reports hoặc các format tương đối cố định.
- Sách mô tả đây là bài toán supervised ML hai giai đoạn:
- Xác định sentence có template hay không.
- Xác định slot fillers cho template, với classifier riêng cho từng slot.
- Đây là task specialized, domain-dependent.
- Sách không biết có off-the-shelf service provider phổ biến nào cho task này.
- BBC coverage of 2019 UK elections là ví dụ real-world cho template-based text generation.
Case Study
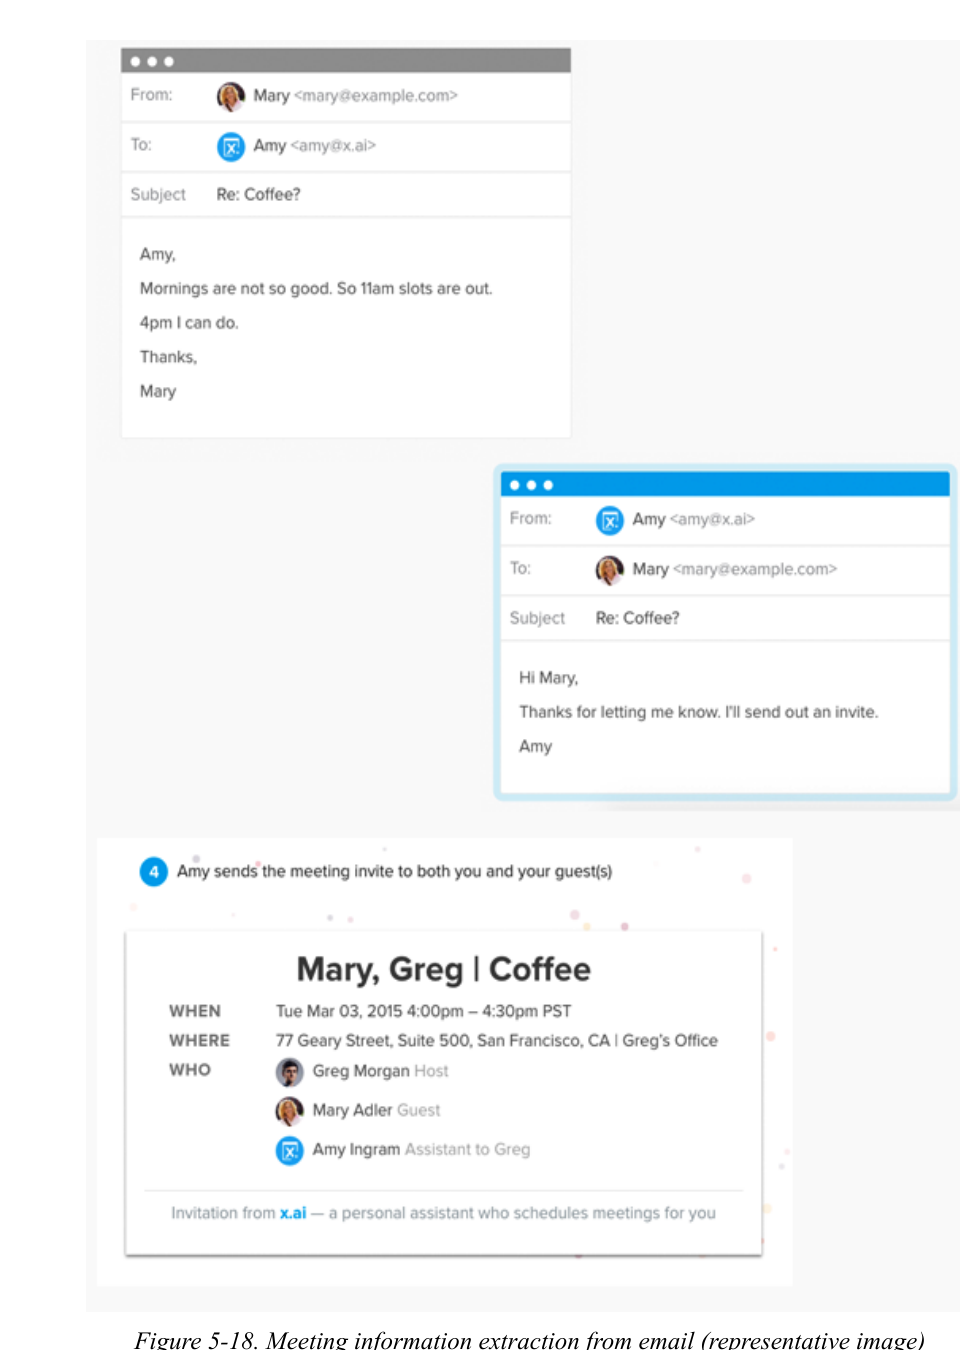
Ý chính: Case study mở đầu bằng luồng email → meeting invite, cho thấy bài toán không chỉ trích entity mà còn phải tạo một workflow nghiệp vụ hoàn chỉnh: nhận ra meeting, date, time, room, invitees và sinh hành động tiếp theo.
Nguồn: Practical Natural Language Processing - Figure 5-18.
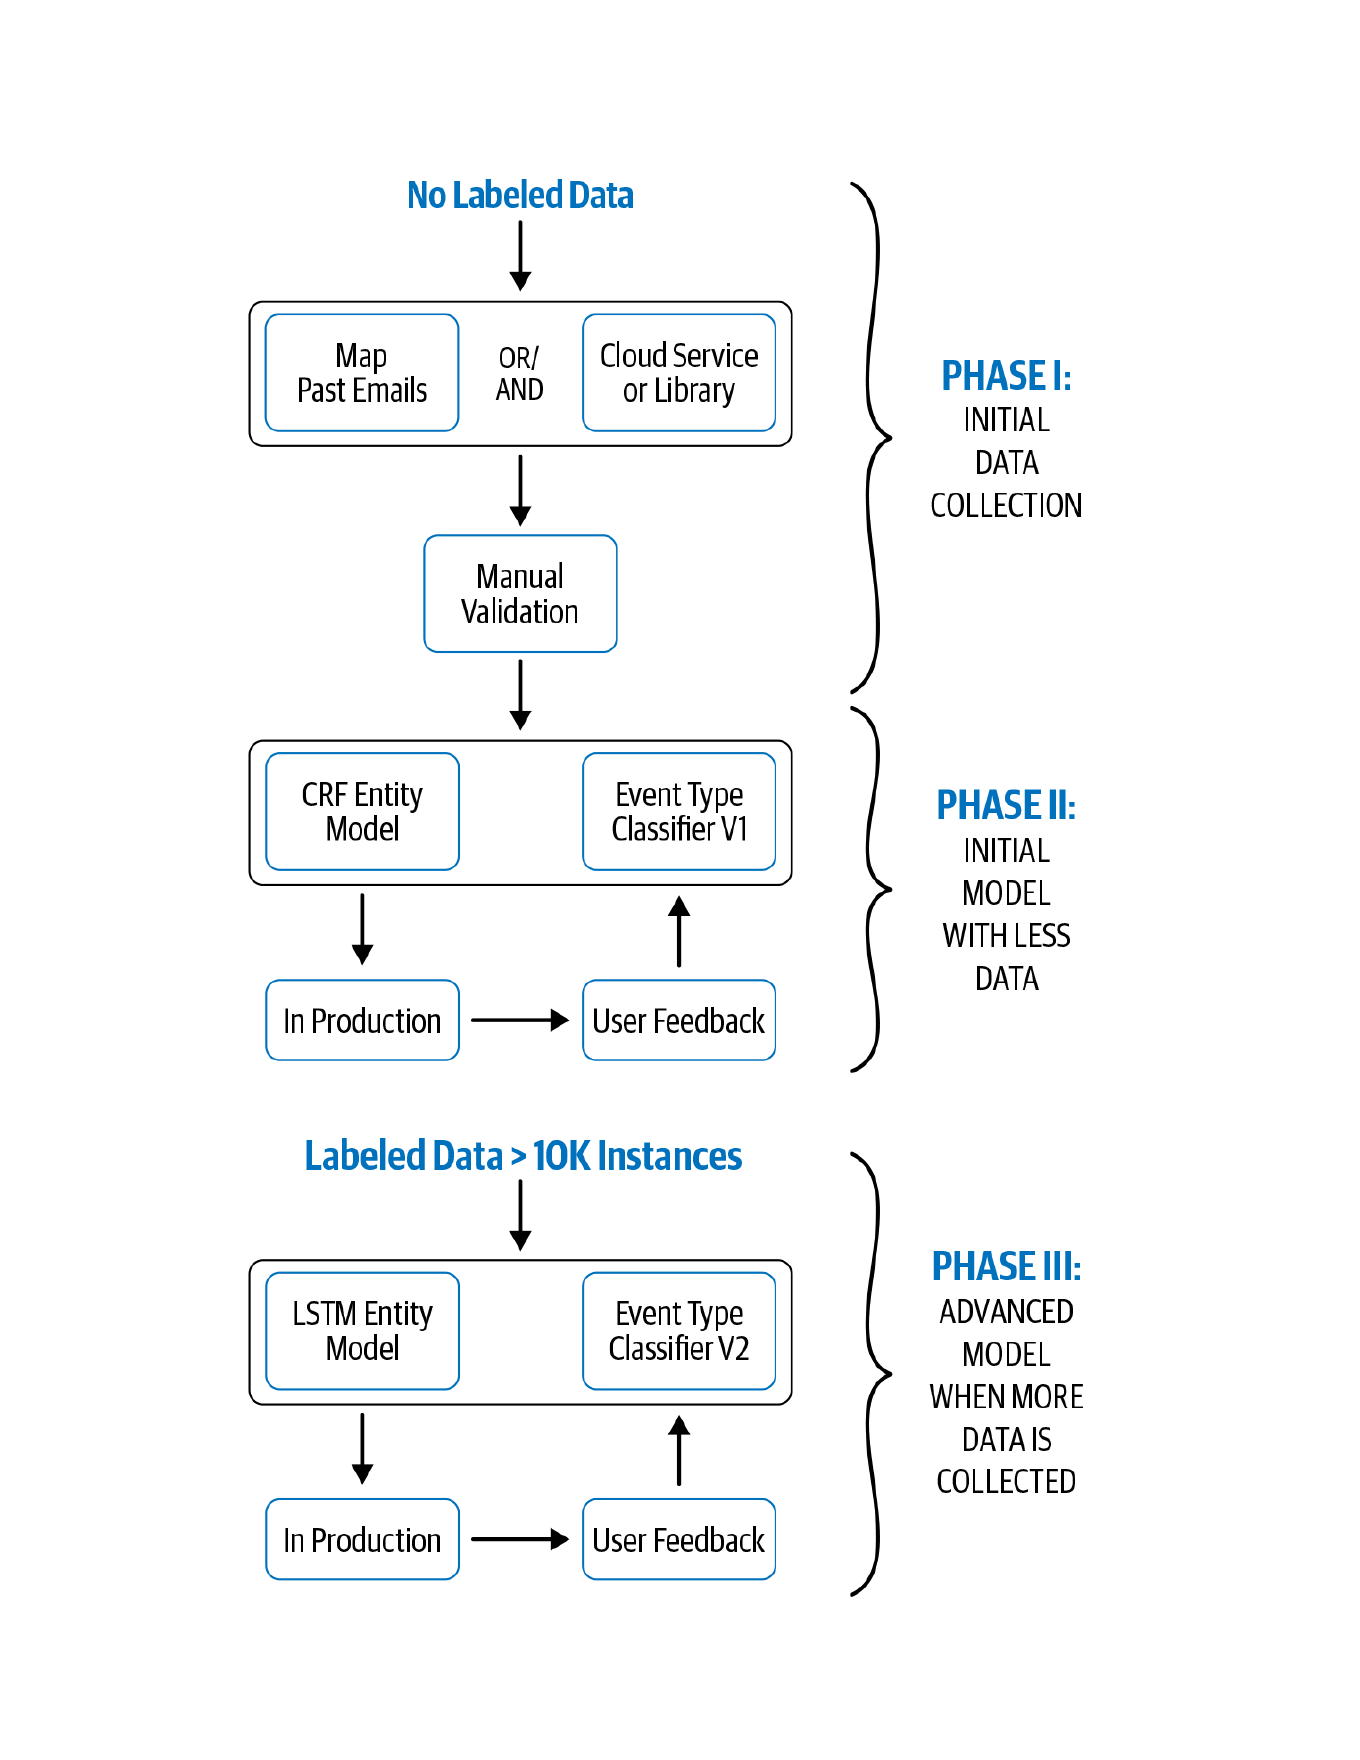
Ý chính: Figure 5-19 cho thấy cách xây hệ thống IE theo pha: bắt đầu bằng rule/cloud service + manual validation, rồi CRF + rule-based classifier, rồi nâng cấp lên LSTM/BERT khi có đủ labeled data.
Nguồn: Practical Natural Language Processing - Figure 5-19.
- Sách kết thúc phần này bằng một meeting extraction system cho enterprise email.
- Giả định ban đầu là one meeting per email để biến bài toán thành MVP rõ ràng hơn.
- Có thể dùng labeled data từ lịch/bookings + email, hoặc dùng weak supervision / bootstrapping từ pre-built services như Google Cloud NLP hay AWS Comprehend.
- Dữ liệu tạo tự động từ service nên được manual validation trước khi train model.
- Với data đủ lớn, có thể dùng CRF cho entity fields và rule-based classifier cho meeting type.
- Khi hệ thống đi vào production, có thể dùng user feedback như accept/reject rates và conflict rates để thu thêm dữ liệu.
- Sau khi đủ khoảng 5–10K labeled sentences, sách gợi ý thử BERT fine-tuning cho phần language understanding.
- Nếu email có multiple meetings hoặc ambiguous mentions, bài toán trở thành multiclass/multilabel khó hơn và có thể cần LSTM/GRU để model context sâu hơn.
- Bài học chung của case study là: bắt đầu nhỏ, bootstrap dữ liệu, kiểm tra thủ công, rồi tăng dần độ phức tạp của model khi dữ liệu và nhu cầu đủ lớn.
Câu hỏi review
- IE khác Text Classification ở câu hỏi đầu ra như thế nào?
- Vì sao tagging news entity hữu ích cho search và recommendation?
- Trong receipt/check scanning, OCR và IE đảm nhiệm hai vai trò khác nhau ra sao?
- NER khác entity linking ở đâu?
- Relationship extraction cần thêm thông tin gì so với nhận diện entity?
- Template filling phù hợp với loại bài toán nào?
- Các task IE trong ví dụ bài báo về Apple đi từ mức đơn giản tới phức tạp như thế nào?
- Vì sao IE trong industry thường là hybrid system thay vì chỉ rule hoặc chỉ ML?
- Vì sao dataset cho IE thường chuyên biệt hơn dataset text classification?
- IE pipeline khác text classification pipeline ở điểm nào?
- Vì sao coreference resolution hữu ích cho entity disambiguation, relation extraction hoặc event extraction?
- Vì sao unsupervised KPE thường phổ biến hơn supervised KPE trong ứng dụng thực tế?
- Graph-based KPE chọn keyphrase quan trọng dựa trên trực giác nào?
- Khi đưa KPE vào production, những lỗi/caveat nào cần xử lý sau extraction?
- Khi implement KPE bằng
textacy, pipeline tối thiểu gồm những bước nào? - Vì sao cần so sánh TextRank, SGRank,
gensimhoặc implementation tự viết trước khi chọn một cách? - Vì sao document length có thể làm KPE graph-based kém ổn định?
- Vì sao top-N keyphrases vẫn cần de-duplication hoặc post-processing trước khi đưa vào product?
- NER khác KPE ở mục tiêu output như thế nào?
- Vì sao NER thường là prerequisite cho relation extraction và event extraction?
- Trong ví dụ “Where was Albert Einstein born?”, NER giúp hệ thống làm bước gì trước khi tìm câu trả lời?
- Khi nào gazetteer là điểm bắt đầu hợp lý cho NER, và giới hạn chính của nó là gì?
- Rule-based NER đi xa hơn lookup table ở điểm nào?
- Vì sao NER được xem là sequence labeling chứ không phải classification độc lập từng từ?
- BIO notation mã hóa multi-word entity như thế nào?
- Named entity disambiguation khác NER ở câu hỏi đầu ra như thế nào?
- Vì sao NEL thường cần parsing hoặc coreference resolution, không chỉ POS tagging?
- Khi nào nên dùng dịch vụ NEL có sẵn thay vì tự train model in-house?
- RE khác NER/NEL ở output cuối cùng như thế nào?
- Vì sao “relation schema” thường phụ thuộc domain?
- Pattern-based RE có trade-off precision/coverage ra sao?
- Supervised RE có thể được tách thành hai bài toán classification nào?
- Distant supervision khác bootstrapping seed pattern ở điểm nào?
- Open IE mạnh và yếu ở đâu khi muốn đưa output vào database chuẩn?
- Vì sao RE service có preset relation list có thể bỏ sót quan hệ mình cần?
Gợi ý trả lời câu hỏi review
- IE vs Text Classification: classification trả một label cho whole document; IE trả ra spans, entities, relations, events hoặc slots có cấu trúc.
- KPE vs NER: KPE tìm cụm từ đại diện cho gist; NER tìm mention có type rõ ràng như person, organization, location.
- NER vs Entity Linking: NER dừng ở span/type; entity linking gán identity cụ thể trong KB như Wikipedia/DBpedia.
- NEL cần parsing và coreference resolution vì nhiều mention khác nhau có thể trỏ cùng một thực thể; context quanh mention là tín hiệu quyết định.
- RE cần entity pair + context + relation schema theo domain; pattern-based thì precision cao nhưng coverage thấp, supervised thì thường là bài toán related/not related rồi relation label.
- Distant supervision sinh noisy labels từ KB lớn; open IE không cần schema cố định nhưng khó map về relation chuẩn.
- Temporal IE gồm extraction + normalization; extraction có thể bằng regex hoặc sequence labeling, normalization phải map biểu thức tương đối như
todayhayFridaysang thời điểm chuẩn. - Event extraction cố hiểu “chuyện gì đã xảy ra” và nối event theo thời gian; sách xem nó là supervised learning problem, thường dùng sequence tagging và multilevel classifiers.
- Template filling hợp với schema cố định: xác định template có xuất hiện không, rồi điền từng slot filler.
- IE production thường là hybrid: bắt đầu bằng rule/bootstrapping/weak supervision, validate tay, sau đó mới nâng cấp model khi có đủ data và feedback.
- Case study meeting extraction cho thấy nên bắt đầu bằng giả định hẹp, bootstrap nhãn từ lịch/email/service, dùng CRF cho entity fields, rồi nâng cấp dần lên BERT/LSTM/GRU.