01 - Reliable, Scalable, and Maintainable Applications
Mục tiêu cần hiểu
- Định nghĩa ba thuộc tính nền: reliability, scalability, maintainability.
- Biết cách mô tả load, performance và cách ứng phó khi load tăng.
- Hiểu maintainability qua operability, simplicity, evolvability.
Định nghĩa quan trọng
- Data system: tập hợp các thành phần lưu trữ và xử lý dữ liệu, được ghép lại để cung cấp một dịch vụ cùng các guarantee xác định. Xem Data System.
- Reliability: hệ tiếp tục hoạt động đúng ở mức performance yêu cầu khi gặp hardware fault, software fault hoặc human error. Xem Reliability.
- Scalability: khả năng có phương án hợp lý để giữ performance khi data volume, traffic hoặc complexity tăng. Xem Scalability.
- Maintainability: khả năng giúp nhiều người vận hành, hiểu và thay đổi hệ thống một cách hiệu quả trong thời gian dài. Xem Maintainability.
- Load parameter: đại lượng mô tả loại load chi phối kiến trúc, chẳng hạn request/second, read/write ratio, active users, cache hit rate hoặc fan-out.
- Response time / latency / percentile: response time là thời gian client quan sát được; latency là thời gian request chờ được xử lý; percentile mô tả phân phối thời gian phản hồi. Xem Latency.
Mental model
Yêu cầu hệ thống
-> reliability: hệ vẫn đúng dù có lỗi
-> scalability: hệ vẫn giữ performance khi load tăng
-> maintainability: con người vẫn vận hành và thay đổi được hệ lâu dài
Thinking About Data Systems
Vì sao cần khái niệm data system?
Database, queue và cache thường được xem là các loại công cụ khác nhau vì access pattern, đặc tính performance và cách triển khai của chúng khác nhau. Tuy nhiên, ranh giới này ngày càng mờ:
- Một công cụ có thể mang đặc tính của nhiều nhóm, chẳng hạn Redis vừa lưu dữ liệu vừa có thể được dùng như message queue.
- Một message queue như Apache Kafka có thể cung cấp durability gần với database.
- Yêu cầu của ứng dụng ngày càng rộng, khiến một công cụ đơn lẻ khó đáp ứng toàn bộ nhu cầu lưu trữ và xử lý dữ liệu.
Từ các công cụ riêng lẻ đến một hệ thống chuyên biệt
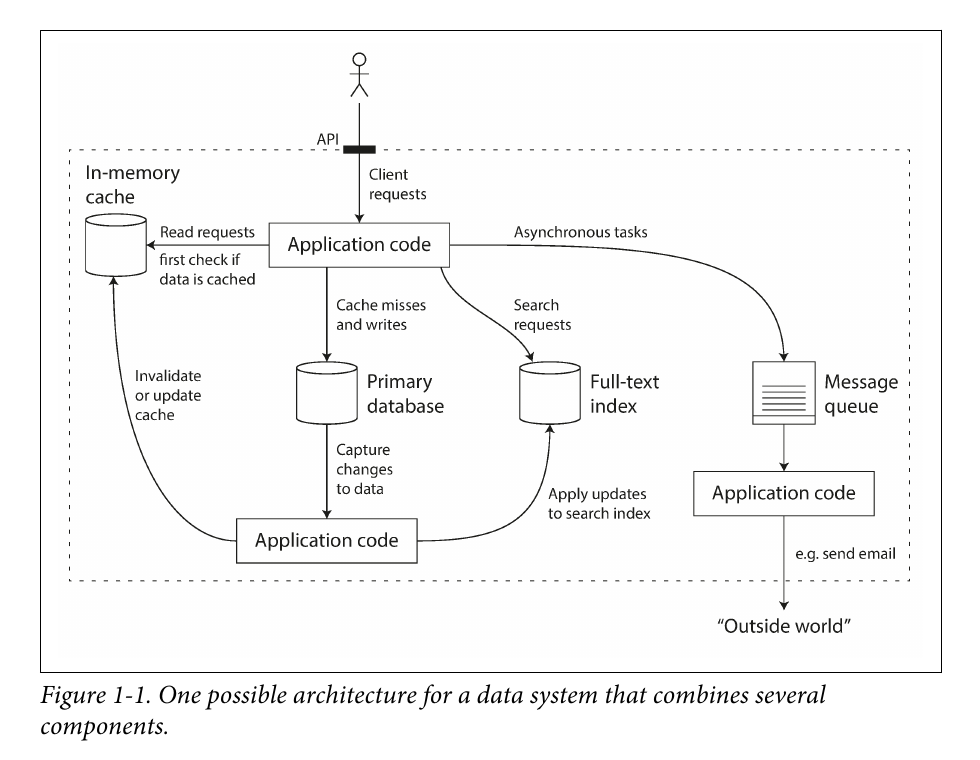
Ý chính: Application code phối hợp primary database, in-memory cache, full-text index và message queue. API che giấu các chi tiết này khỏi client, nên tổ hợp đó trở thành một data system chuyên biệt. Nguồn: Designing Data-Intensive Applications — Figure 1-1, trang 5.
Client
-> API
-> Application code
   -> cache cho read path
   -> primary database cho write và cache miss
   -> full-text index cho search
   -> message queue cho asynchronous task
-> application code giữ cache và index đồng bộ với database
Khi ghép nhiều công cụ, application code phải chia công việc cho thành phần phù hợp và duy trì quan hệ giữa chúng. Ví dụ trong hình, thay đổi ở primary database phải được phản ánh sang cache và search index.
Trách nhiệm chuyển từ tool sang người thiết kế hệ thống
API có thể giấu cấu trúc nội bộ, nhưng không tự tạo ra guarantee. Khi cung cấp một service từ nhiều thành phần, developer đồng thời trở thành data system designer và phải quyết định hệ thống sẽ bảo đảm điều gì, chẳng hạn cache được invalidate hoặc update đúng lúc để client nhận kết quả nhất quán.
Các câu hỏi thiết kế cốt lõi:
- Làm sao dữ liệu vẫn đúng và đầy đủ khi một phần bên trong gặp sự cố?
- Làm sao giữ performance ổn định khi một thành phần bị degraded?
- Làm sao mở rộng khi load tăng?
- API nào diễn đạt đúng service contract mà không làm lộ chi tiết triển khai?
Không có kiến trúc đúng cho mọi bối cảnh
Thiết kế còn phụ thuộc vào năng lực đội ngũ, hệ thống legacy, thời hạn giao hàng, mức chấp nhận rủi ro và ràng buộc pháp lý. Vì vậy, chọn data system là bài toán đánh đổi theo bối cảnh, không chỉ là chọn công cụ có nhiều tính năng nhất.
Kết luận cần nhớ
Một ứng dụng ghép database, cache, index và queue qua application code đã trở thành một data system. Chất lượng của hệ phụ thuộc vào guarantee và cách phối hợp giữa các thành phần, không chỉ vào từng công cụ riêng lẻ.
Reliability
Định nghĩa vận hành
Một hệ reliable không chỉ “không sập”. Nó phải tiếp tục:
- thực hiện đúng chức năng người dùng mong đợi;
- chịu được thao tác sai hoặc cách sử dụng bất ngờ;
- giữ performance đủ cho use case dưới load và data volume dự kiến;
- ngăn truy cập hoặc lạm dụng trái phép.
Từ đó, reliability có thể hiểu là tiếp tục hoạt động đúng khi có điều bất lợi xảy ra.
Fault khác failure
Fault: một thành phần lệch khỏi đặc tả
        ↓ nếu không được cô lập hoặc xử lý
Failure: toàn hệ thống không còn cung cấp service yêu cầu cho user
Không thể đưa xác suất fault về zero. Mục tiêu thực tế của fault tolerance là ngăn fault cục bộ lan thành failure ở cấp hệ thống. Khái niệm “tolerant” luôn cần nêu rõ loại fault nào nằm trong phạm vi xử lý; không hệ nào chịu được mọi tình huống.
Fault-tolerant system đôi khi chủ động tạo fault, chẳng hạn kill ngẫu nhiên một process, để liên tục kiểm tra recovery mechanism thay vì chỉ hy vọng nó hoạt động khi sự cố thật xảy ra. Tuy nhiên, với hậu quả không thể đảo ngược như dữ liệu nhạy cảm đã bị lộ, phòng ngừa quan trọng hơn phục hồi.
Hardware Faults
Hardware fault gồm disk crash, RAM lỗi, mất điện hoặc cáp mạng bị rút nhầm. Với một máy đơn, những sự kiện này có vẻ hiếm; ở quy mô lớn, xác suất tổng hợp trở nên đáng kể.
Nguồn nêu MTTF của hard disk khoảng 10–50 năm. Điều đó không có nghĩa cluster 10.000 disk sẽ yên ổn hàng chục năm: xét trung bình, quy mô này có thể gặp khoảng một disk hỏng mỗi ngày.
Cách tiếp cận truyền thống: redundancy trong từng máy
- RAID cho disk.
- Dual power supply.
- Hot-swappable CPU.
- Battery và diesel generator cho datacenter.
Khi một component hỏng, component dự phòng tiếp quản trong lúc phần hỏng được thay thế. Cách này giảm xác suất machine failure nhưng không loại bỏ hoàn toàn sự cố.
Dịch chuyển sang software fault tolerance
Khi data volume và compute demand tăng, số machine tăng theo và hardware fault xảy ra thường xuyên hơn. Cloud platform cũng có thể làm virtual machine biến mất bất ngờ vì ưu tiên flexibility và elasticity hơn độ tin cậy của từng machine.
Machine A mất
-> traffic/work chuyển sang machine khác
-> service vẫn tiếp tục
-> machine A được thay hoặc sửa độc lập
Hệ chịu được mất cả machine còn cho phép rolling upgrade: patch từng node mà không cần planned downtime cho toàn service. Bài học là reliability nên được thiết kế ở boundary của service, không đặt cược toàn bộ vào một server “rất bền”.
Software Errors
Hardware fault thường ngẫu nhiên và tương đối độc lập. Software error thường có tính systematic và correlated: cùng code và cùng assumption có thể làm nhiều node hỏng đồng thời.
Các failure mode được nguồn nêu:
- Một bad input kích hoạt bug khiến mọi application instance crash; leap second năm 2012 là ví dụ về một điều kiện hiếm tác động đồng thời tới nhiều hệ thống.
- Runaway process dùng hết CPU, memory, disk hoặc network bandwidth dùng chung.
- Dependency trở nên chậm, không phản hồi hoặc trả corrupted response.
- Cascading failure: fault nhỏ ở một component kích hoạt chuỗi fault ở component khác.
Software bug có thể nằm im lâu vì assumption về môi trường thường đúng, cho đến một điều kiện hiếm khiến assumption đó sai.
Assumption ẩn
-> điều kiện hiếm phá vỡ assumption
-> nhiều instance cùng phản ứng sai
-> shared resource/dependency bị ảnh hưởng
-> cascading failure
Không có một bản vá duy nhất cho systematic fault. Tập biện pháp gồm:
- suy nghĩ rõ về assumption và interaction giữa component;
- test kỹ, đặc biệt corner case;
- process isolation;
- cho phép process crash rồi restart;
- đo, monitor và phân tích production behavior;
- liên tục kiểm tra invariant khi chạy, ví dụ số message vào và ra phải khớp, rồi alert khi có sai lệch.
Điểm quan trọng: replication không giúp nếu mọi replica chạy cùng bug. Redundancy chỉ hữu ích khi failure mode của các bản sao đủ độc lập hoặc fault được cô lập.
Human Errors
Con người thiết kế, cấu hình và vận hành hệ thống nên human error là một phần của system model. Nguồn dẫn nghiên cứu về large internet services: configuration error của operator là nguyên nhân hàng đầu gây outage, trong khi hardware fault chỉ liên quan tới khoảng 10–25% outage.
Thiết kế để giảm cơ hội sai
- Abstraction, API và admin interface nên làm thao tác đúng dễ thực hiện và cảnh báo thao tác nguy hiểm.
- Không nên khóa interface quá chặt; nếu công cụ cản trở công việc hợp lệ, operator sẽ tìm workaround và làm mất tác dụng bảo vệ.
- Tách nơi dễ mắc lỗi khỏi nơi gây failure bằng non-production sandbox đầy đủ, cho phép thử nghiệm gần với dữ liệu thật mà không ảnh hưởng real user.
Giới hạn blast radius và phục hồi nhanh
- Test từ unit, integration đến whole-system và manual test.
- Rollback configuration nhanh.
- Rollout code dần để bug chỉ ảnh hưởng một tập user nhỏ.
- Có công cụ recompute dữ liệu khi kết quả cũ sai.
Tạo khả năng quan sát và học hỏi
- Thu thập telemetry như performance metric và error rate.
- Dùng monitoring để phát hiện early warning, constraint hoặc assumption bị vi phạm.
- Duy trì management practice và training tốt.
Mục tiêu không phải loại bỏ con người, mà là thiết kế hệ để một sai sót đơn lẻ khó biến thành outage lớn và dễ được phát hiện, đảo ngược.
How Important Is Reliability?
Reliability không chỉ dành cho nuclear plant hay air traffic control. Business application lỗi có thể làm mất năng suất, tạo legal risk vì số liệu sai; ecommerce outage gây mất doanh thu và uy tín; photo application làm mất ảnh gia đình có thể gây thiệt hại không thể thay thế.
Mức reliability cần thiết
= giá trị và tính không thể thay thế của dữ liệu
+ hậu quả của downtime hoặc kết quả sai
+ kỳ vọng của user
+ chi phí xây dựng và vận hành guarantee
Có tình huống chấp nhận giảm reliability để giảm development cost, chẳng hạn prototype cho thị trường chưa được kiểm chứng, hoặc giảm operational cost cho service có biên lợi nhuận rất thấp. Nhưng đây phải là quyết định có ý thức:
- Guarantee nào đang được cắt?
- User sẽ quan sát failure nào?
- Dữ liệu có thể khôi phục không?
- Chi phí failure có thực sự thấp hơn chi phí phòng ngừa và recovery không?
Kết luận của phần này không phải “luôn tối đa hóa reliability”, mà là không được hy sinh nó một cách vô thức.
Scalability
Scalability là một câu hỏi, không phải nhãn dán
Nói “hệ này scalable” là chưa đủ. Cần chỉ rõ:
- Load parameter nào đang tăng?
- Nếu giữ nguyên CPU, memory và network, performance thay đổi ra sao?
- Muốn giữ performance không đổi, cần tăng resource bao nhiêu?
Load parameter phụ thuộc kiến trúc: requests/second, read/write ratio, concurrent users, cache hit rate, data size hoặc một nhóm extreme case gây bottleneck.
Describing Load
Trước khi hỏi hệ có scale hay không, cần mô tả load hiện tại bằng một tập nhỏ load parameters. Parameter đúng phụ thuộc kiến trúc và bottleneck:
- requests/second tới web server;
- read/write ratio của database;
- số user đồng thời trong chat room;
- cache hit rate;
- data volume hoặc payload size;
- một extreme case hiếm nhưng chi phối capacity.
Average chưa chắc đủ. Nếu workload có skew lớn, distribution hoặc phần đuôi của distribution mới là thứ quyết định kiến trúc.
Ví dụ Twitter: chuyển chi phí giữa read path và write path
Nguồn dùng số liệu Twitter công bố tháng 11/2012:
- Post tweet: trung bình 4.6k request/second, peak hơn 12k request/second.
- Read home timeline: khoảng 300k request/second.
- Thách thức chính không phải số tweet, mà là fan-out do mỗi user theo dõi và được theo dõi bởi nhiều người.
Cách 1: tính timeline khi đọc, fan-out on read
Post tweet -> ghi một lần vào global tweet collection
Read timeline -> lấy danh sách followee
              -> đọc tweet của từng followee
              -> merge và sort theo thời gian
Ưu điểm là write rẻ. Nhược điểm là mỗi lần đọc phải join và merge nhiều nguồn; Twitter ban đầu dùng cách này nhưng hệ thống không theo kịp lượng home timeline query.
Cách 2: tính timeline khi ghi, fan-out on write
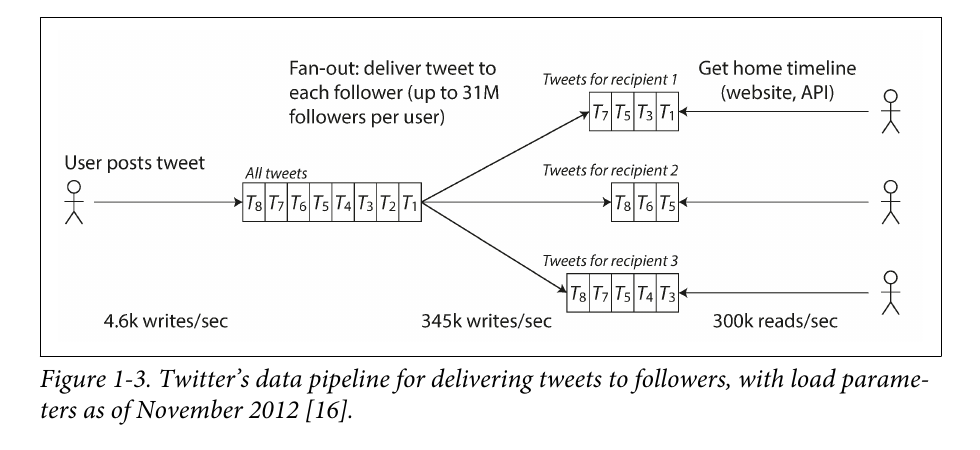
Ý chính: Tweet mới được đẩy trước vào cache timeline của từng follower. Read trở nên rẻ vì kết quả đã được tính sẵn, nhưng write bị khuếch đại theo số follower. Nguồn: Designing Data-Intensive Applications — Figure 1-3, trang 12.
User posts tweet
-> ghi tweet
-> tìm toàn bộ follower
-> chèn tweet vào home-timeline cache của từng follower
-> user đọc trực tiếp timeline đã materialize
Với trung bình 75 follower, 4.6k tweet/second trở thành khoảng 345k cache write/second. Trung bình này che giấu skew: một celebrity có hơn 30 triệu follower có thể tạo hơn 30 triệu write từ một tweet, trong khi mục tiêu là phân phối trong khoảng năm giây.
fan-out write rate ≈ tweet rate × số follower nhận tweet

4.6k tweet/s × 75 follower trung bình ≈ 345k timeline write/s
Công thức trung bình chỉ dùng để định hướng. Capacity planning phải xét distribution follower và tần suất đăng của từng nhóm user, vì một celebrity tweet có thể tạo load cao hơn rất nhiều so với average.
Cách 3: hybrid
Twitter sau đó dùng fan-out on write cho phần lớn user, nhưng không fan-out trước tweet của một số user có lượng follower cực lớn. Khi đọc timeline, hệ thống lấy riêng tweet của các celebrity rồi merge vào kết quả đã materialize.
Điểm cần nhớ: load parameter quan trọng không chỉ là tweet/second, mà là phân phối follower trên mỗi user, có thể còn phải weighted theo tần suất user đó đăng tweet. Hybrid architecture xử lý phần đuôi của phân phối thay vì tối ưu cho một giá trị trung bình gây hiểu lầm.
Describing Performance
Sau khi mô tả load, scalability được phân tích qua hai câu hỏi:
- Khi tăng load parameter nhưng giữ nguyên CPU, memory và network, performance suy giảm thế nào?
- Khi tăng load parameter, cần tăng resource bao nhiêu để giữ performance không đổi?
- Batch system: quan tâm throughput, tức records/second hoặc tổng thời gian hoàn tất job.
- Online system: thường quan tâm response time mà client nhìn thấy.
- Response time là một distribution, không phải một con số cố định.
Response time khác latency theo cách dùng chặt trong nguồn:
response time mà client thấy
= queueing delay
+ service time
+ network delay

latency
= thời gian request nằm chờ trước khi được xử lý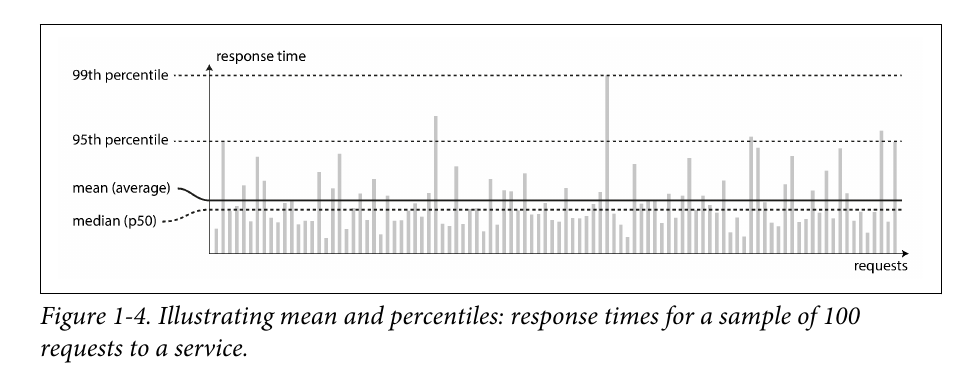
Ý chính: Mean không cho biết bao nhiêu user thật sự gặp độ trễ đó. p50 mô tả trải nghiệm điển hình; p95, p99 và p99.9 cho thấy tail latency. Nguồn: Designing Data-Intensive Applications — Figure 1-4, trang 14.
Queueing delay và head-of-line blocking có thể làm request vốn xử lý nhanh vẫn có response time cao. Với một end-user request gọi nhiều backend, chỉ một backend call chậm cũng có thể làm toàn request chậm, tạo tail latency amplification. Vì vậy nên đo từ phía client và không lấy trung bình của các percentile; khi tổng hợp cần cộng histogram.
Percentile cần đọc như thế nào?
- p50 = 200 ms: một nửa request nhanh hơn 200 ms, một nửa chậm hơn.
- p95 = 1.5 s: 95/100 request nhanh hơn 1.5 s, 5/100 request bằng hoặc chậm hơn ngưỡng đó.
- p99 và p99.9 mô tả tail latency, nơi một nhóm nhỏ user có thể chịu trải nghiệm rất tệ.
Một user session thường tạo nhiều request, nên xác suất có ít nhất một request chậm cao hơn tỷ lệ của từng request đơn lẻ. Với backend fan-out, một call chậm có thể giữ toàn bộ end-user response lại.
Bẫy khi load test và tổng hợp metric
- Load generator phải tiếp tục gửi request độc lập với response time. Nếu đợi request trước xong mới gửi request sau, test sẽ giữ queue ngắn giả tạo và đánh giá quá tốt hệ thống.
- Đo response time từ phía client để bao gồm queueing và network delay.
- Không lấy trung bình p99 của nhiều machine hoặc time window; phải hợp nhất histogram rồi tính lại percentile.
- Tối ưu percentile càng cao càng tốn kém và có diminishing return; target cần gắn với SLO/SLA và giá trị thực tế.
Approaches for Coping with Load
- Scale up: dùng machine mạnh hơn; thường đơn giản hơn nhưng có giới hạn và chi phí cao.
- Scale out: phân tán load qua nhiều machine; cần chấp nhận complexity của shared-nothing architecture.
- Elastic scaling: tự động thêm resource khi load tăng; hữu ích với load khó đoán nhưng có thêm hành vi vận hành cần kiểm soát.
- Manual scaling: đơn giản và dễ dự đoán hơn, nhưng đòi hỏi capacity planning.
Stateless service tương đối dễ phân tán; stateful data system phức tạp hơn nhiều. Không có kiến trúc scale chung cho mọi workload: 100k request/second, mỗi request 1 KB khác hoàn toàn 3 request/minute, mỗi request 2 GB, dù data throughput có thể tương đương.
Decision framework
Load tăng theo dimension nào?
-> đọc / ghi / data volume / payload / concurrency / fan-out
-> performance target nào phải giữ?
-> bottleneck nằm ở compute, memory, disk, network hay coordination?
-> scale up có đủ và rẻ hơn không?
-> nếu scale out, state và rebalancing được xử lý thế nào?
-> elastic hay manual phù hợp với độ biến động của load?
Kiến trúc scale tốt luôn dựa trên assumption về operation nào phổ biến và operation nào hiếm. Nếu assumption sai, effort scaling có thể bị lãng phí hoặc phản tác dụng. Với startup hoặc sản phẩm chưa được kiểm chứng, khả năng iterate nhanh thường quan trọng hơn tối ưu cho hypothetical future load.
Một architecture phù hợp với load hiện tại có thể không chịu được mức tăng 10 lần. Khi service tăng qua từng order of magnitude, có thể phải xem lại kiến trúc thay vì chỉ thêm machine.
Maintainability
Phần lớn chi phí software nằm sau lần phát triển đầu tiên: vận hành, sửa bug, điều tra failure, cập nhật platform, trả technical debt và thích nghi với use case mới. Maintainability nhằm làm cho công việc dài hạn đó bớt đau đớn qua ba nguyên tắc.
Operability: Making Life Easy for Operations
Operations không chỉ phản ứng khi production sập. Họ giữ hệ thống chạy ổn định qua toàn bộ vòng đời:
- theo dõi health và nhanh chóng khôi phục service khi hệ rơi vào bad state;
- tìm root cause của failure hoặc degraded performance;
- cập nhật software, platform và security patch;
- theo dõi cách các system tác động lẫn nhau để chặn change nguy hiểm trước khi deploy;
- dự báo vấn đề tương lai, đặc biệt capacity planning;
- thiết lập practice và tool cho deployment, configuration management;
- thực hiện maintenance phức tạp như migration platform;
- giữ security khi configuration thay đổi;
- định nghĩa process có thể dự đoán để production ổn định;
- bảo toàn organizational knowledge khi con người đến và rời team.
Một ý quan trọng của nguồn: operations tốt thường có thể bù cho giới hạn của software chưa hoàn thiện, nhưng software tốt không thể tự chạy reliable nếu operations kém. Automation cần thiết, nhưng con người vẫn phải thiết kế, kiểm tra và giám sát automation đó.
Data system hỗ trợ operability như thế nào?
- Cung cấp visibility vào runtime behavior và internals qua monitoring.
- Hỗ trợ automation và tích hợp standard tools.
- Tránh phụ thuộc vào một machine riêng lẻ để machine có thể được maintenance mà service vẫn chạy.
- Có documentation và operational model rõ: “nếu làm X, Y sẽ xảy ra”.
- Cung cấp default tốt nhưng cho administrator override khi cần.
- Self-heal ở nơi phù hợp nhưng vẫn có manual control.
- Hành vi predictable, giảm surprise trong incident và change.
Visibility + predictable control
-> phát hiện sớm
-> chẩn đoán nhanh
-> can thiệp có kiểm soát
-> khôi phục service
-> học từ incident
Xem concept Operability.
Simplicity: Managing Complexity
Khi system lớn lên, complexity làm mọi người chậm lại và tăng maintenance cost. Một system quá rối thường được mô tả là “big ball of mud”.
Triệu chứng complexity
- State space bùng nổ.
- Module tight coupling.
- Dependency đan xen khó lần theo.
- Naming và terminology không nhất quán.
- Performance hack che khuất thiết kế ban đầu.
- Special case dùng để bù cho vấn đề ở nơi khác.
Khi engineer khó reasoning về system, hidden assumption, unintended consequence và unexpected interaction dễ bị bỏ sót; thay đổi nhỏ cũng có thể tạo bug ở nơi xa.
Essential và accidental complexity
Simplicity không có nghĩa giảm chức năng. Cần tách:
- Essential complexity: độ phức tạp vốn có của bài toán người dùng.
- Accidental complexity: độ phức tạp phát sinh từ cách triển khai, không thuộc bản chất bài toán.
Mục tiêu là loại accidental complexity. Công cụ mạnh nhất là abstraction tốt: che implementation detail phía sau interface rõ và có thể dùng lại.
Ví dụ của nguồn:
- High-level programming language che machine code, CPU register và syscall.
- SQL che on-disk/in-memory data structure, concurrent request và nhiều chi tiết xử lý inconsistency sau crash.
Abstraction không làm detail biến mất; nó giúp phần lớn user của abstraction không phải xử lý detail đó trực tiếp. Tìm abstraction tốt cho distributed system vẫn khó vì cần che complexity mà không che mất failure mode quan trọng.
Xem concept Simplicity.
Evolvability: Making Change Easy
Requirement hiếm khi đứng yên. Chúng thay đổi khi team học thêm, use case mới xuất hiện, business priority đổi, user yêu cầu feature, platform được thay thế, regulation đổi hoặc system growth buộc kiến trúc thay đổi.
Agile, TDD và refactoring hỗ trợ thay đổi ở phạm vi code cục bộ. DDIA mở rộng câu hỏi lên data-system level:
- Nhiều application hoặc service có đặc tính khác nhau sẽ thay đổi cùng nhau thế nào?
- Data flow, storage và API guarantee nào cần migration?
- Làm sao refactor kiến trúc trong khi system vẫn phục vụ user?
Twitter home timeline là ví dụ: chuyển từ fan-out on read sang fan-out on write, rồi hybrid, không phải sửa một function mà là thay đổi data flow, cache strategy và load distribution của cả system.
Simplicity + abstraction rõ
-> engineer hiểu boundary và assumption
-> dự đoán impact của change
-> migration có thể chia nhỏ và kiểm chứng
-> system thích nghi với requirement mới
Evolvability còn được gọi là extensibility, modifiability hoặc plasticity. Nó gắn chặt với simplicity: system dễ hiểu thường dễ thay đổi hơn. Xem concept Evolvability.
Quan hệ giữa ba yếu tố
| Yếu tố | Câu hỏi chính |
|---|---|
| Reliability | Khi có fault, hệ còn cung cấp đúng service không? |
| Scalability | Khi load tăng theo một dimension cụ thể, performance và resource thay đổi thế nào? |
| Maintainability | Con người có thể vận hành, hiểu và thay đổi hệ hiệu quả trong nhiều năm không? |
Ba yếu tố không độc lập: scale out có thể cải thiện capacity nhưng làm operability và simplicity khó hơn; abstraction có thể tăng maintainability nhưng phải giữ đúng reliability guarantee; automation có thể hỗ trợ scale nhưng cũng tạo failure mode mới.
Summary
Hai lớp yêu cầu của một ứng dụng
- Functional requirements: hệ phải làm được gì, chẳng hạn lưu, truy xuất, tìm kiếm và xử lý dữ liệu.
- Nonfunctional requirements: hệ phải có những phẩm chất nào, chẳng hạn security, reliability, compliance, scalability, compatibility và maintainability.
Chapter 1 tập trung vào ba nonfunctional requirements tạo thành khung tư duy cho phần còn lại của sách.
Ba trụ cột cần nhớ
Data-intensive application
|
|-- Reliability
|   -> tiếp tục hoạt động đúng khi có hardware, software hoặc human fault
|   -> fault tolerance ngăn fault cục bộ trở thành failure user nhìn thấy
|
|-- Scalability
|   -> mô tả load và performance bằng số đo cụ thể
|   -> có chiến lược thêm capacity để giữ performance khi load tăng
|
`-- Maintainability
    -> Operability: dễ quan sát và vận hành
    -> Simplicity: kiểm soát accidental complexity
    `-> Evolvability: dễ thích nghi với requirement mới
Reliability
Hardware fault thường ngẫu nhiên và tương đối độc lập; software fault thường systematic và khó xử lý; human error là không thể tránh hoàn toàn. Reliability đến từ việc thiết kế boundary, detection, isolation và recovery để che một số loại fault khỏi end user.
Scalability
Scalability cần load parameter và performance metric định lượng. Ví dụ Twitter cho thấy average request rate chưa đủ; fan-out distribution có thể quyết định bottleneck. Response-time percentile cho biết trải nghiệm phần đuôi tốt hơn mean. Khi load tăng, hệ cần strategy tăng processing capacity mà vẫn giữ reliability.
Maintainability
Maintainability nhằm cải thiện cuộc sống của engineering và operations team. Abstraction tốt giảm complexity và hỗ trợ thay đổi; operability tốt cung cấp visibility, predictable control và cách quản lý system hiệu quả.
Quan hệ giữa ba trụ cột
Fault xảy ra
-> Reliability quyết định service có tiếp tục đúng không

Load tăng
-> Scalability quyết định resource/architecture thay đổi thế nào

System sống lâu và requirement đổi
-> Maintainability quyết định con người có vận hành và tiến hóa hệ được không
Một hệ chỉ “scale được” nhưng khó vận hành không phải thiết kế tốt. Một hệ dễ thay đổi nhưng không giữ correctness khi có fault cũng không đủ. Ba yếu tố cần được đánh giá cùng nhau tại boundary mà user quan sát.
Checklist áp dụng Chapter 1
- Functional requirement và nonfunctional requirement nào thực sự quan trọng?
- Fault model gồm hardware, software và human failure mode nào?
- Load parameter nào chi phối bottleneck, đặc biệt ở tail của distribution?
- Performance được đo bằng throughput hay response-time percentile nào?
- Khi load tăng, sẽ scale up, scale out, elastic hay manual?
- Operations có đủ visibility và control để giữ system ổn định không?
- Accidental complexity nằm ở đâu và abstraction nào có thể loại bỏ nó?
- Requirement thay đổi sẽ tác động đến data flow, API và guarantee nào?
Ý chính cuối chương
Không có một kỹ thuật đơn lẻ biến ứng dụng thành reliable, scalable và maintainable. Giá trị của chương nằm ở bộ câu hỏi và mental model; các chương tiếp theo sẽ phân tích những pattern và technique lặp lại trong nhiều loại data system, rồi xem chúng phục vụ ba mục tiêu này như thế nào.
Khi áp dụng
- Dùng chương này làm checklist đầu vào trước khi chọn database, queue, cache, storage engine hay kiến trúc phân tán.
Câu hỏi review
- Reliability khác availability ở điểm nào?
- Vì sao percentile quan trọng hơn average khi nói về latency?
- Khi load tăng, vì sao không có một kiến trúc scale chung cho mọi hệ?
Liên kết
- Book: Designing Data-Intensive Applications
- Concepts: Data System, Reliability, Scalability, Maintainability, Operability, Simplicity, Evolvability, Latency, Distributed Systems
- PDF: PDF tr. 25