Scalability
Định nghĩa
Scalability là khả năng có phương án hợp lý để giữ performance khi một load parameter cụ thể tăng. Đây không phải nhãn “scalable/non-scalable”; nó là quan hệ giữa loại load, mức tăng, performance target và resource cần thêm.
Khung phân tích
Chọn load parameter
-> đo load hiện tại
-> chọn performance metric
-> tăng load trong mô hình hoặc thử nghiệm
-> quan sát performance khi resource giữ nguyên
-> tính resource cần thêm để giữ performance
-> chọn thay đổi kiến trúc phù hợp
Load parameter có thể là requests/second, read/write ratio, concurrent users, cache hit rate, data volume, payload size hoặc fan-out distribution.
Describing Load
Load phải được mô tả bằng parameter phản ánh bottleneck thực tế, chẳng hạn requests/second, read/write ratio, concurrent users, cache hit rate, data volume, payload size hoặc fan-out distribution. Average có thể không đủ khi workload bị skew.
Ví dụ Twitter home timeline
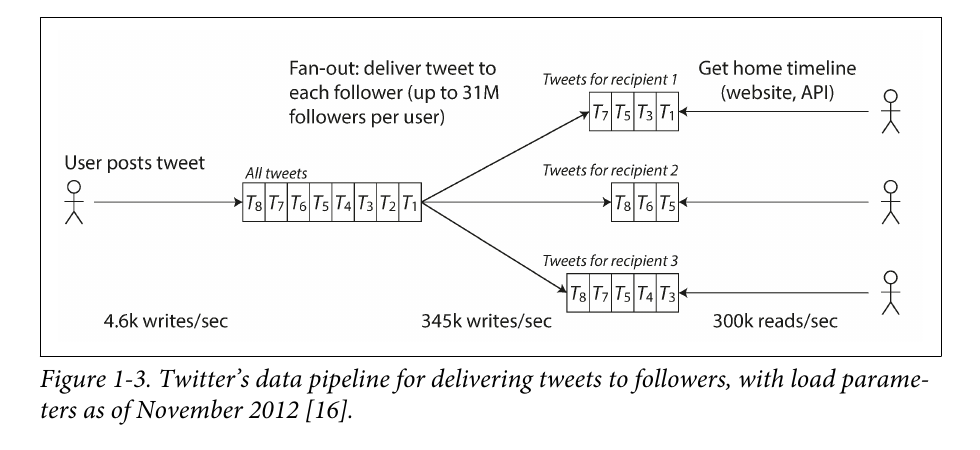
Nguồn mô tả ba chiến lược:
- Fan-out on read: ghi tweet một lần; khi đọc thì lấy followee, query tweet rồi merge. Write rẻ, read đắt.
- Fan-out on write: đẩy tweet vào timeline cache của từng follower. Read rẻ, write bị khuếch đại.
- Hybrid: fan-out on write cho phần lớn user; celebrity được đọc và merge riêng để tránh một write tạo hàng chục triệu update.
Với 4.6k tweet/second và trung bình 75 follower, hệ tạo khoảng 345k timeline-cache write/second. Nhưng load parameter quyết định kiến trúc là phân phối follower, không chỉ số trung bình, vì một user có thể có hơn 30 triệu follower.
fan-out write rate ≈ tweet rate × số follower nhận tweetCapacity planning phải dùng distribution follower và tần suất đăng, không chỉ average, vì tail của distribution quyết định peak fan-out.
Describing Performance
Hai câu hỏi cần đo:
- Giữ resource cố định, performance thay đổi thế nào khi load tăng?
- Muốn giữ performance cố định, resource phải tăng bao nhiêu?
- Batch: throughput hoặc thời gian hoàn tất một dataset.
- Online: response-time distribution quan sát từ client.
- p50: trải nghiệm điển hình của một request.
- p95/p99/p99.9: tail latency và nhóm request chậm.
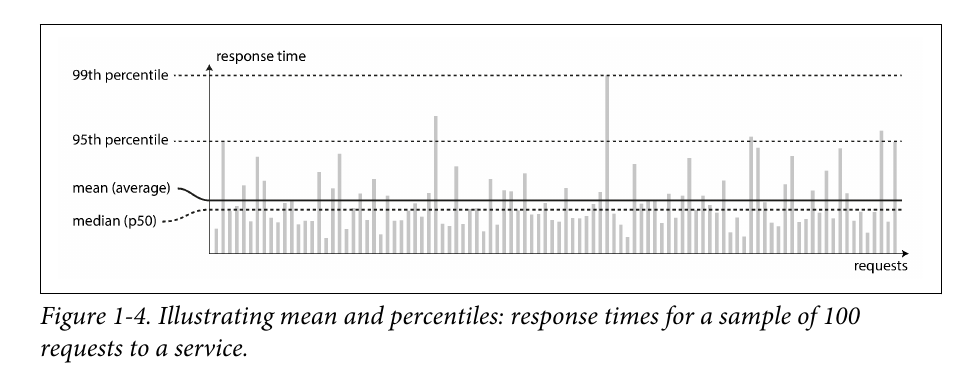
Mean có thể che giấu outlier. Queueing delay, head-of-line blocking và việc một user request gọi nhiều backend có thể khuếch đại tail latency. Khi tổng hợp percentile giữa nhiều machine hoặc time window, cần tổng hợp histogram thay vì lấy trung bình các percentile.
Load test cần gửi request độc lập với response time; nếu client chờ response rồi mới gửi request tiếp theo, queue trong test ngắn hơn production và kết quả bị lạc quan. Metric nên được đo từ client boundary.
Approaches for Coping with Load
| Chiến lược | Lợi ích | Chi phí |
|---|---|---|
| Scale up | Đơn giản hơn, ít coordination | Machine mạnh đắt và có giới hạn |
| Scale out | Chia tải qua nhiều machine | Coordination, state và vận hành phức tạp hơn |
| Elastic | Phản ứng với load khó đoán | Nhiều hành vi tự động và operational surprise |
| Manual | Dễ dự đoán, mô hình đơn giản | Cần capacity planning và phản ứng của con người |
Stateful system khó scale out hơn stateless service. Kiến trúc phải khớp workload thực tế; tối ưu cho load giả định ở tương lai có thể làm chậm khả năng thử nghiệm sản phẩm hiện tại.
Không có kiến trúc scale dùng chung cho mọi hệ. Cùng data throughput nhưng workload 100k request/s × 1 KB và 3 request/minute × 2 GB tạo bottleneck, concurrency và resource profile hoàn toàn khác nhau.
Khi lựa chọn chiến lược, cần xác định:
- dimension load đang tăng;
- performance target cần giữ;
- resource hoặc coordination point đang nghẽn;
- state được đặt ở đâu khi scale out;
- load đủ biến động để cần elasticity hay có thể capacity-plan thủ công;
- architecture assumption có còn đúng ở order of magnitude tiếp theo không.
Câu hỏi review
- Load parameter nào thực sự quyết định bottleneck?
- Nếu load gấp đôi và resource giữ nguyên, metric nào xấu đi?
- Nếu muốn giữ p99, cần thêm bao nhiêu resource hoặc đổi read/write path thế nào?
- Phần đuôi của phân phối load có phá vỡ kiến trúc dựa trên average không?