Distilling the Knowledge in a Neural Network
Tóm tắt một câu
Paper đề xuất huấn luyện một mô hình nhỏ gọn (student) bằng các phân phối xác suất mềm (soft targets) từ mô hình lớn hoặc ensemble (teacher) ở nhiệt độ softmax cao, qua đó truyền đạt cấu trúc tương đồng giữa các lớp (dark knowledge) và khả năng tổng quát hóa mà nhãn cứng (hard labels) không thể biểu diễn được. PDF tr. 2
Nguồn
- arXiv: 1503.02531, version v1, published 2015-03-09.
- PDF trong vault: Distilling the Knowledge in a Neural Network.pdf
- Hội thảo: NIPS 2014 Deep Learning Workshop.
Vấn đề paper giải quyết
Một mô hình lớn (cumbersome model) hoặc một tập hợp nhiều mô hình (ensemble) thường có khả năng tổng quát hóa (generalization) vượt trội so với một mô hình đơn lẻ. Tuy nhiên, việc triển khai (deployment) toàn bộ ensemble trong môi trường sản xuất thực tế đòi hỏi tài nguyên tính toán và độ trễ quá lớn. PDF tr. 1
Paper đặt ra bài toán: làm thế nào để chuyển giao tri thức (knowledge transfer) từ mô hình cồng kềnh sang một mô hình nhỏ gọn hơn để dễ dàng phục vụ suy luận?
Điểm mấu chốt mang tính triết lý của bài báo: Tri thức không đồng nhất với trọng số của mạng neural. Tri thức thực chất là một hàm ánh xạ (mapping) từ vector đầu vào sang vector đầu ra, thể hiện qua cách mô hình phân bổ xác suất giữa các lớp và mối tương quan giữa chúng. PDF tr. 1
Gap và đóng góp
- Kỹ thuật Softmax Temperature: Phát triển hướng tiếp cận nén mô hình của Bucilua et al. (2006) bằng cách đưa tham số nhiệt độ vào hàm softmax, cho phép điều chỉnh độ mượt của phân phối xác suất thay vì chỉ khớp trực tiếp các logit thô. PDF tr. 2
- Chứng minh toán học chặt chẽ: Formalize mối liên hệ giữa chưng cất tri thức và phương pháp khớp logits (matching logits). Paper chứng minh rằng matching logits bằng sai số bình phương (MSE) thực chất là trường hợp đặc biệt của distillation khi nhiệt độ và logits được chuẩn hóa zero-mean theo từng mẫu. PDF tr. 3
- Thực nghiệm đa miền:
- MNIST: Student model nhỏ bé đạt 74 lỗi kiểm thử (gần bằng mức 67 lỗi của mạng lớn có dropout), vượt xa mức 146 lỗi của baseline nhỏ cùng kiến trúc. Đặc biệt, student vẫn nhận dạng được số 3 ngay cả khi toàn bộ số 3 bị xóa khỏi tập dữ liệu chuyển giao (transfer set). PDF tr. 4
- Nhận dạng tiếng nói (ASR): Chuyển giao hơn 80% mức cải thiện độ chính xác khung hình (frame accuracy) từ ensemble 10 mô hình sang một mô hình đơn duy nhất, đạt WER tương đương ensemble (10,7%). PDF tr. 5
- Bộ dữ liệu quy mô cực lớn (JFT): Đề xuất kiến trúc gồm một mô hình tổng quát (generalist) và các mô hình chuyên gia (specialists) tập trung vào các cụm lớp dễ nhầm lẫn, cho phép huấn luyện song song quy mô lớn. PDF tr. 6
- Tác dụng điều hòa (Regularization): Chứng minh soft targets hoạt động như một bộ điều hòa cực mạnh trong điều kiện dữ liệu hạn chế (chỉ dùng 3% dữ liệu huấn luyện tiếng nói mà không bị overfitting nghiêm trọng). PDF tr. 8
Bài toán/formalization
Cho một mẫu đầu vào, mô hình sinh ra vector logits trên lớp. Xác suất dự đoán cho lớp được tính qua hàm softmax có nhiệt độ :
Trong đó:
- là tham số nhiệt độ (temperature). Khi , ta thu được hàm softmax tiêu chuẩn.
- Khi tăng cao, phân phối trở nên “mềm” hơn, khuếch đại xác suất của các lớp có điểm số thấp để làm lộ rõ cấu trúc tương đồng giữa các lớp. PDF tr. 2
Hàm mục tiêu chưng cất (Distillation Objective)
Gọi là logit của mô hình teacher, là logit của student. Phân phối mục tiêu từ teacher tại nhiệt độ là:
Khi huấn luyện student với sự kết hợp giữa soft targets từ teacher và nhãn thật (hard labels ):
Trong đó:
- là cross-entropy tiêu chuẩn giữa student logits và ground-truth one-hot labels (tại ).
- là cross-entropy (tương đương Kullback-Leibler Divergence ) giữa soft targets của teacher và student (tại nhiệt độ ).
- Hệ số : Cần nhân với để bù trừ sự suy giảm độ lớn của gradient khi tăng (do gradient của soft loss tỉ lệ nghịch với ), đảm bảo sự cân bằng đóng góp tương đối giữa soft loss và hard loss khi thay đổi . PDF tr. 3
Phương pháp
Quy trình chưng cất tri thức tiêu chuẩn:
[Teacher / Ensemble lớn]
        │
        ▼ (forward với temperature T cao)
[Soft Targets p_i] (Chứa Dark Knowledge)
        │
        ├─────────────────────────────┐
        ▼                             ▼
[Soft Loss * T^2]              [Hard Loss] (T=1)
(Khớp phân phối mềm)           (Khớp nhãn thật)
        │                             │
        └──────────────┬──────────────┘
                       ▼
        [Cập nhật trọng số Student]
                       │
                       ▼
         [Deploy Student tại T=1]
Bản chất của “Dark Knowledge”
Nhãn cứng (one-hot) chỉ cho biết lớp đúng, triệt tiêu hoàn toàn thông tin về sự nhầm lẫn giữa các lớp sai. Ví dụ:
- Một ảnh con chó có thể có xác suất nhỏ là “mèo” nhưng xác suất là “xe tải” gần như bằng 0.
- Một chữ số
2viết tay có thể có nét vòng giống số3, hoặc có nét gạch giống số7.
Soft targets giữ lại toàn bộ bản đồ tương quan này. Nhờ đó, student không chỉ học được ranh giới quyết định mà còn học được không gian biểu diễn mượt mà và cách tổng quát hóa của teacher. PDF tr. 2
Mental model
Hard label là “đáp án cuối cùng”; Soft target là “bài giải chi tiết có ghi chú các lỗi thường gặp”. Student học từ soft targets giống như một học sinh học từ bài thi đã được chấm và ghi chú chi tiết bởi người thầy giỏi: học sinh biết phương án nào đúng, và các phương án sai khác thì sai ở mức độ nào.
Công thức quan trọng
1. Đạo hàm của hàm mất mát chưng cất theo student logit
Đạo hàm của hàm cross-entropy theo logit của student tại nhiệt độ là:
2. Xấp xỉ chuỗi Taylor tại giới hạn nhiệt độ cao ()
Khi nhiệt độ rất lớn so với độ lớn của các logits ( và ), ta áp dụng xấp xỉ bậc nhất :
Giả định rằng các logits đã được chuẩn hóa zero-mean theo từng mẫu ( và ):
Do đó, hiệu xác suất là:
Thay vào biểu thức gradient ban đầu:
Tích phân biểu thức gradient này cho thấy: tại nhiệt độ cao, việc tối thiểu hóa cross-entropy tương đương với việc tối thiểu hóa hàm sai số bình phương giữa các logits:
Ý nghĩa:
- Khớp logits trực tiếp (Bucilua et al., 2006) chỉ là trường hợp biên khi .
- Khi dùng nhiệt độ hữu hạn vừa phải, distillation có ưu điểm vượt trội: nó bỏ qua (ít phạt hơn) các logits âm rất lớn (các lớp hoàn toàn không liên quan), giúp student không bị phân tâm bởi nhiễu của các lớp nền. PDF tr. 3
Experimental setup
1. Phân loại chữ số viết tay (MNIST)
- Teacher: Mạng 2 hidden layers, mỗi layer 1200 đơn vị ReLU, regularized bằng dropout và ràng buộc độ dài vector trọng số (max-norm), dữ liệu huấn luyện jitter tối đa 2 pixels. Đạt 67 test errors. PDF tr. 3
- Student baseline: Mạng 2 hidden layers, mỗi layer 800 ReLU, không regularization. Đạt 146 test errors.
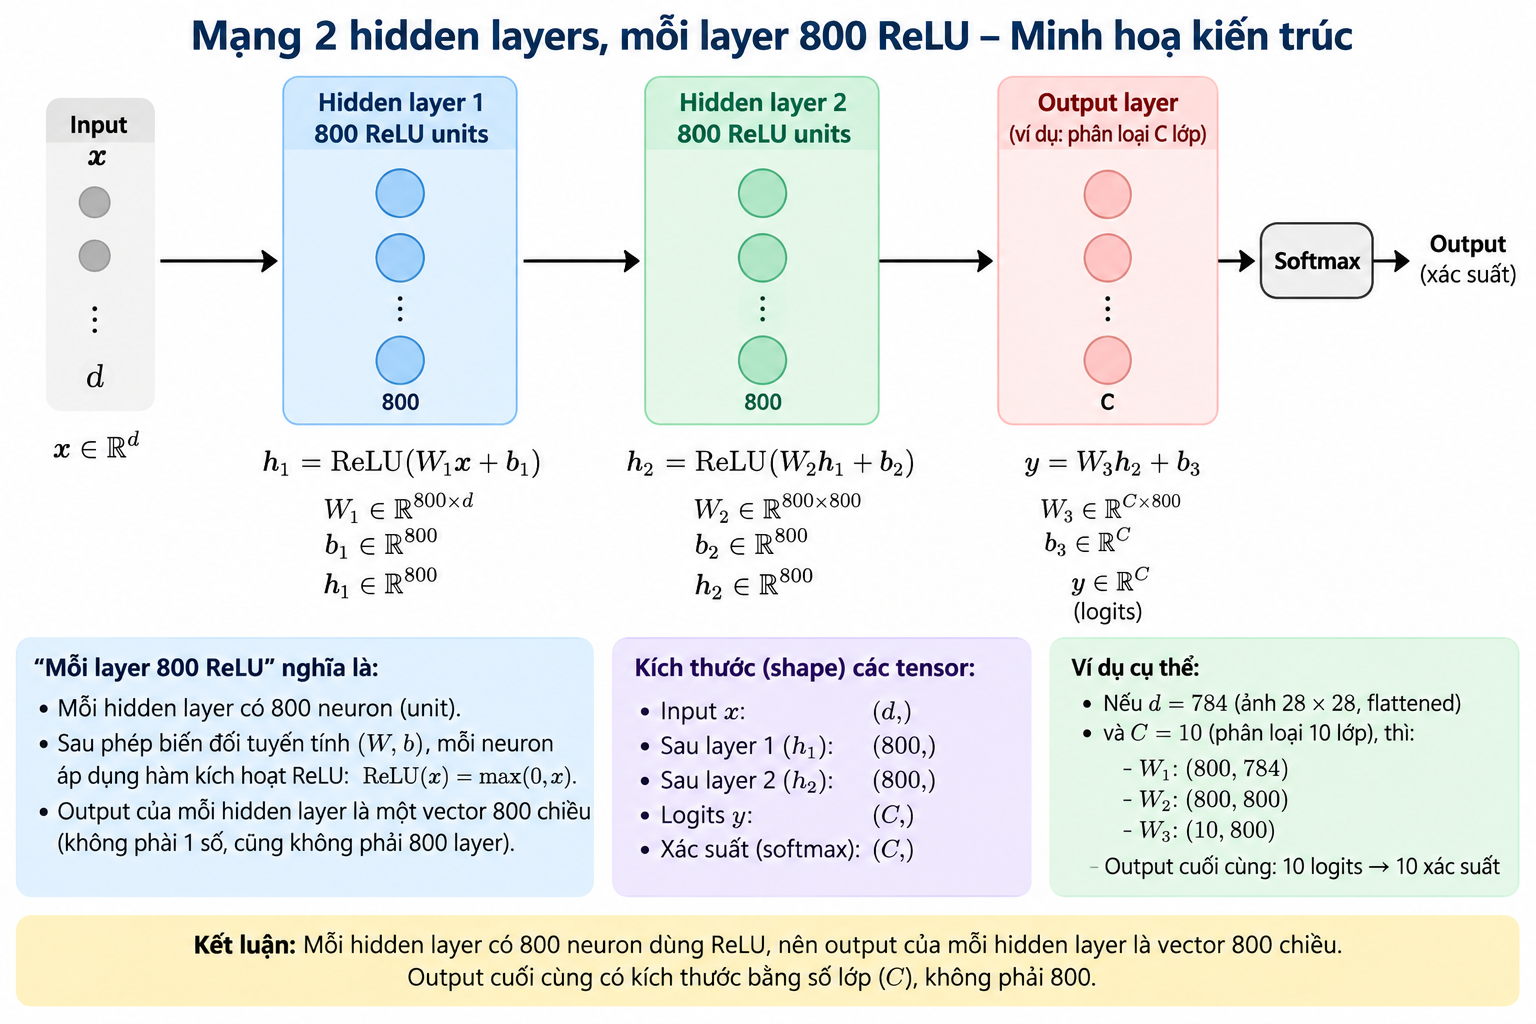
Minh họa Student baseline: Student nhận vector đầu vào , đi qua hai hidden layer 800 ReLU rồi tới output logits/softmax. “Mỗi layer 800 ReLU” nghĩa là mỗi hidden layer có 800 neuron và xuất ra vector 800 chiều, không phải 800 layer.
- Distillation: Student 800-800 được train khớp soft targets của teacher ở . PDF tr. 4
2. Mô hình âm học trong nhận dạng tiếng nói (ASR)
- Kiến trúc: DNN gồm 8 hidden layers, mỗi layer 2560 đơn vị ReLU, softmax phân loại 14.000 HMM states, khoảng 85M tham số.
- Tập dữ liệu: 2000 giờ tiếng Anh đàm thoại, khoảng 700 triệu khung hình (frames).
- Teacher: Ensemble gồm 10 mô hình độc lập cùng kiến trúc.
- Student: Mô hình đơn lẻ học từ ensemble với và trọng số nhãn thật là 0,5. PDF tr. 4 PDF tr. 5
3. Tập dữ liệu ảnh khổng lồ (JFT Specialists)
- Dữ liệu: Tập dữ liệu JFT nội bộ của Google với 100 triệu ảnh trên 15.000 nhãn.
- Mô hình tổng quát (Generalist): Mạng tích chập lớn huấn luyện trên toàn bộ 15.000 lớp.
- Mô hình chuyên gia (Specialists): 61 mạng chuyên gia, mỗi mạng chỉ tập trung vào một cụm lớp dễ nhầm lẫn (được phân cụm dựa trên ma trận hiệp phương sai của dự đoán từ generalist). Các lớp không thuộc cụm được gộp vào một lớp rác (dustbin class). Specialist được khởi tạo từ trọng số của generalist để tiết kiệm thời gian hội tụ. PDF tr. 5 PDF tr. 6
Protocol fingerprint
| Trường | Giá trị |
|---|---|
| Nhiệm vụ chính | Image Classification / Acoustic Modeling (ASR) / Large-scale Multi-class Image Recognition |
| Mô hình Teacher | Mạng nơ-ron lớn regularized bằng dropout hoặc ensemble 10 DNNs |
| Mô hình Student | Mô hình đơn lẻ nhỏ hơn, tối ưu cho tốc độ và bộ nhớ khi serving |
| Tín hiệu chưng cất | Soft targets tại nhiệt độ cao (), kết hợp hard labels |
| Hàm mất mát | |
| Độ đo chính | Số lỗi phân loại (MNIST); Frame Accuracy & Word Error Rate (WER) trong ASR; Top-1 Accuracy (JFT) |
| Phân loại kết quả | Báo cáo từ bài báo gốc (reported/observed). Không tái lập nội bộ |
Kết quả chính
1. Thực nghiệm MNIST
| Hệ thống | Số lỗi tập Test (trên 10.000 mẫu) | Ghi chú |
|---|---|---|
| Large Net + Dropout + Jitter (Teacher) | 67 | Baseline mạnh nhất |
| Small Net không Regularization (Student baseline) | 146 | Baseline độc lập |
| Small Net + Hard Labels + Dropout | 147 | Dropout không giúp mạng nhỏ |
| Small Net Distilled () | 74 | Giảm gần 50% số lỗi so với small baseline |
Thực nghiệm loại bỏ số 3: Khi loại bỏ hoàn toàn chữ số 3 khỏi tập transfer set (tập test vẫn có 1010 số 3), mô hình distilled chỉ mắc 206 lỗi trên số 3 (tức nhận dạng đúng gần 80% số 3 dù chưa từng thấy nhãn số 3 trong quá trình chuyển giao). Điều này khẳng định soft targets từ các chữ số khác (như 2 hoặc 7) đã âm thầm truyền đạt thông tin về hình thái của số 3. PDF tr. 4
2. Thực nghiệm nhận dạng tiếng nói (Bảng 1)
| Hệ thống | Test Frame Accuracy | Word Error Rate (WER) |
|---|---|---|
| Baseline (1 DNN) | 58,9% | 10,9% |
| Ensemble 10 DNNs | 61,1% | 10,7% |
| Distilled Single Model | 60,8% | 10,7% |
Nhận xét: Distilled single model đạt mức WER ngang ngửa ensemble 10 mô hình và chuyển giao được hơn 86% mức tăng trưởng frame accuracy của ensemble, nhưng chi phí suy luận chỉ bằng 1 mô hình đơn lẻ. PDF tr. 5
3. Tác dụng điều hòa khi thiếu dữ liệu (Bảng 5)
| Hệ thống & Dữ liệu huấn luyện | Train Frame Accuracy | Test Frame Accuracy |
|---|---|---|
| Baseline (100% data - 700M frames) | 63,4% | 58,9% |
| Baseline Hard Labels (3% data - 20M frames) | 67,3% | 44,5% (overfitting nặng) |
| Distilled Soft Targets (3% data - 20M frames) | 65,4% | 57,0% (chỉ cách full data 1,9%) |
Soft targets ngăn chặn overfitting một cách đáng kinh ngạc: với chỉ 3% dữ liệu huấn luyện, mô hình học từ soft targets đạt 57,0% độ chính xác test, vượt xa mô hình học từ hard labels (44,5%). PDF tr. 8
Ablation và phân tích
- Ảnh hưởng của nhiệt độ theo dung lượng Student:
- Khi student có dung lượng vừa phải (từ 300 units/layer trở lên trên MNIST), nhiệt độ từ 8 đến 20 cho kết quả tốt tương đương nhau.
- Khi student rất nhỏ (30 units/layer), nhiệt độ tối ưu rơi vào khoảng . Nhiệt độ quá cao khiến student bị ép khớp toàn bộ các logits âm vô nghĩa, vượt quá dung lượng biểu diễn của mạng nhỏ. PDF tr. 4
- Hệ thống Specialists trên JFT:
- 61 mô hình specialists giúp tăng top-1 test accuracy từ 25,0% lên 26,1% (+4,4% relative gain).
- Độ chính xác tăng mạnh nhất ở các lớp được bao phủ bởi nhiều specialist models. PDF tr. 7
Hạn chế, giả định, failure modes
- Phụ thuộc dữ liệu nội bộ: Các thực nghiệm ấn tượng nhất về quy mô (ASR trên Google Voice Search và JFT trên 100M ảnh) đều sử dụng dữ liệu và hạ tầng độc quyền của Google, không thể tái lập công khai. PDF tr. 4 PDF tr. 5
- Giới hạn dung lượng của Student (Capacity Gap): Nếu student quá nhỏ so với teacher, việc ép student học toàn bộ phân phối mềm có thể phản tác dụng (cần chọn thấp hơn hoặc dùng kỹ thuật Teacher Assistant).
- Chưa chưng cất ngược từ Specialists về Single Net: Nhóm tác giả thừa nhận chưa thể chưng cất toàn bộ tri thức của tập hợp các specialist models trở lại một mô hình đơn duy nhất. PDF tr. 8
Đánh giá từ evidence
- Phương pháp luận có sức ảnh hưởng bậc nhất trong lịch sử Deep Learning: công thức thanh lịch, trực giác sắc bén và ứng dụng trải dài từ Computer Vision đến NLP và Speech.
- Minh chứng thực nghiệm khẳng định: lợi ích của distillation không chỉ dừng lại ở nén mô hình (compression), mà còn là một cơ chế chuyển giao tri thức cấu trúc (dark knowledge transfer) và điều hòa (regularization) mạnh mẽ.
Diễn giải học tập
Mối liên hệ với Continual Learning và Continual Relation Extraction (CRE / TAPTA)
Trong bài toán Học tăng cường (Continual Learning), chưng cất tri thức là vũ khí cốt lõi để chống lại hiện tượng quên thảm khốc (Catastrophic Forgetting), điển hình là dòng phương pháp kế thừa từ Learning without Forgetting (LwF - Li & Hoiem, 2016).
Khi áp dụng KD vào Continual Relation Extraction (CRE), câu hỏi thiết kế sống còn (được ghi nhận trong Reading Queue và Paper Decisions) là:
“KD trong TAPTA nên distill logits hay similarity distribution?”
Dưới góc nhìn của paper Hinton et al. và bản chất hình học của CRE:
1. Distill Logits (Logit-based Distillation)
- Cơ chế: Mô hình teacher (checkpoint sau task ) sinh logits trên các quan hệ cũ; student (đang train trên task ) sinh logits . Loss là .
- Điểm yếu chí mạng trong CRE:
- Trong Few-Shot CRE (ConPL, CPL, WAVE++, TAPTA), mô hình không dùng linear classifier cố định mà dùng phân loại dựa trên metric / prototype ().
- Biên độ tuyệt đối của logits rất nhạy cảm với hiện tượng trôi prototype (prototype drift) và sự mất cân bằng số lượng mẫu giữa task mới và task cũ.
- Ép student khớp biên độ logits tuyệt đối của teacher làm giảm tính linh hoạt của không gian biểu diễn mới.
2. Distill Similarity Distribution (Representation / Relational Distillation)
- Cơ chế: Thay vì ép khớp logits tuyến tính, ta tính phân phối độ tương đồng cosine giữa vector biểu diễn của mẫu với tập hợp các relation prototypes cũ :
- Ưu thế vượt trội:
- Bất biến với độ lớn tuyệt đối của vector đặc trưng (norm-invariant), chỉ tập trung bảo toàn góc và cấu trúc tương đồng tương đối giữa các quan hệ.
- Bảo tồn “Dark Knowledge” về hình thái quan hệ: một câu quan hệ
per:city_of_birthvẫn duy trì khoảng cách gần vớiper:cities_of_residencehơn làorg:founded. - Hoàn toàn tương thích với cơ chế định tuyến prompt (Prompt Router) và không gian metric của TAPTA.
Quyết định cho TAPTA (Decision): Nên distill Similarity Distribution (hoặc Relational Contrastive Geometry) thay vì Logits thô. Việc khớp phân phối tương đồng cosine giữa mẫu và các prototypes cũ tại nhiệt độ sẽ bảo vệ mô hình khỏi hiện tượng quên mà không gây xung đột với việc học prompt của task mới.
Ghi chú cá nhân
(Dành cho ghi chú riêng của người dùng)
Câu hỏi review
Câu 1: Tại sao soft targets từ mô hình teacher lại chứa nhiều thông tin hữu ích hơn nhãn cứng (one-hot)?
Gợi ý trả lời: Nhãn cứng chỉ cung cấp 1 bit thông tin về lớp đúng, triệt tiêu toàn bộ quan hệ tương đồng giữa các lớp sai. Soft targets phản ánh phân phối xác suất liên tục trên toàn bộ không gian lớp, chứa “dark knowledge” về sự tương đồng ngữ nghĩa (ví dụ: chữ số 2 giống 3 hơn giống 7, BMW giống xe rác ở cấu trúc cơ khí hơn củ cà rốt).
Câu 2: Trong hàm mất mát kết hợp hard loss và soft loss, tại sao phải nhân gradient của soft targets với ?
Gợi ý trả lời: Vì trong xấp xỉ nhiệt độ cao, gradient của soft loss tỉ lệ nghịch với (). Khi thay đổi nhiệt độ , nếu không nhân với , độ lớn của gradient soft loss sẽ bị suy giảm mạnh khi lớn, làm mất cân bằng tương quan đóng góp giữa soft loss và hard loss.
Câu 3: Mối liên hệ toán học giữa chưng cất tri thức softmax và việc khớp trực tiếp logits bằng MSE là gì?
Gợi ý trả lời: Khi nhiệt độ và các logits được chuẩn hóa zero-mean theo từng mẫu (), việc tối thiểu hóa cross-entropy của soft targets bằng khai triển Taylor bậc nhất sẽ hội tụ chính xác về việc tối thiểu hóa sai số bình phương trung bình (MSE) giữa logits của student và teacher.
Câu 4: Khi nào việc khớp logits bằng MSE kém hiệu quả hơn chưng cất ở nhiệt độ hữu hạn vừa phải?
Gợi ý trả lời: Khớp logits bằng MSE ép student phải khớp cả các logits có giá trị âm rất lớn (các lớp hoàn toàn không liên quan), vốn chứa nhiều nhiễu ngẫu nhiên từ quá trình huấn luyện của teacher. Distillation ở nhiệt độ hữu hạn vừa phải cho phép bỏ qua các lớp âm sâu này và chỉ tập trung vào các lớp có xác suất tương đối đáng kể.
Evidence map
| Luận điểm / Nội dung | Trang PDF | Bằng chứng cụ thể trong nguồn |
|---|---|---|
| Khái niệm Distillation & Dark Knowledge | Distilling the Knowledge in a Neural Network.pdf | Mục 1: Tri thức là ánh xạ từ input sang output vector |
| Softmax Temperature & Ví dụ BMW/Carrot | Distilling the Knowledge in a Neural Network.pdf | Mục 2 & Eq. 1: Định nghĩa softmax với nhiệt độ |
| Đạo hàm gradient & Chứng minh quy về MSE () | Distilling the Knowledge in a Neural Network.pdf | Eq. 2, 3, 4: Khai triển Taylor và nhân cho gradient |
| Thực nghiệm MNIST & Thí nghiệm bỏ số 3 | Distilling the Knowledge in a Neural Network.pdf | Mục 3: 67 / 146 / 74 test errors; nhận diện đúng 80% số 3 |
| Thực nghiệm Speech Recognition (ASR) | Distilling the Knowledge in a Neural Network.pdf | Bảng 1: Distilled model đạt 60,8% frame acc và 10,7% WER |
| Cấu trúc Specialists & Clustering trên JFT | Distilling the Knowledge in a Neural Network.pdf | Mục 5 & Bảng 2: Phân cụm covariance, dustbin class |
| Kết quả JFT Specialists | Distilling the Knowledge in a Neural Network.pdf | Bảng 3 & Bảng 4: Tăng 4,4% relative accuracy |
| Soft targets như bộ điều hòa khi thiếu dữ liệu | Distilling the Knowledge in a Neural Network.pdf | Bảng 5: 3% data đạt 57,0% so với 44,5% của hard labels |
| Thảo luận & Hạn chế chưa distill ngược specialist | Distilling the Knowledge in a Neural Network.pdf | Mục 7: Caveat về việc nén specialist về single net |
Liên kết
- Khái niệm: Knowledge Distillation, KL Divergence, Continual Relation Extraction
- Papers Continual Learning sử dụng KD:
- Kế hoạch đọc & Quyết định: Reading Queue và Paper Decisions\n