02 - Data Models and Query Languages
Mục tiêu cần hiểu
- Hiểu Data Model là một lớp abstraction quyết định cách ta nghĩ về dữ liệu và thao tác trên dữ liệu.
- So sánh relational, document và graph model theo hình dạng quan hệ, access pattern và khả năng thay đổi.
- Phân biệt schema-on-write với schema-on-read; không đánh đồng “schemaless” với “không có cấu trúc”.
- Giải thích vì sao Declarative Query Language trao quyền tối ưu thực thi cho database.
- Nhận biết khi nào many-to-many và traversal có độ sâu biến đổi khiến Graph Data Model tự nhiên hơn.
Định nghĩa quan trọng
- Data model: ngôn ngữ và abstraction dùng để biểu diễn dữ liệu, quan hệ và thao tác hợp lệ trên dữ liệu. Xem Data Model.
- Relational model: biểu diễn dữ liệu bằng relation, thường được triển khai dưới dạng table gồm các row không có thứ tự.
- Document model: gom dữ liệu thành document tự chứa, thường là JSON/BSON; phù hợp khi aggregate có cấu trúc cây và thường được đọc cùng nhau. Xem Document Store.
- Object-relational mismatch: khác biệt giữa object graph trong application và table/row trong relational database. Xem Object-Relational Mismatch.
- Schema-on-write: database kiểm tra schema khi ghi; cấu trúc được khai báo và cưỡng chế trước khi dữ liệu được lưu.
- Schema-on-read: reader diễn giải cấu trúc khi đọc; schema vẫn tồn tại nhưng thường nằm trong application code.
- Declarative query: mô tả kết quả cần lấy, không bắt buộc chỉ ra trình tự thực thi. Xem Declarative Query Language.
- Property graph: graph gồm vertex và edge có identifier cùng tập property; edge còn có label và hướng. Xem Property Graph.
- Triple-store: lưu mọi thông tin dưới dạng
(subject, predicate, object); object có thể là primitive value hoặc vertex khác. - Datalog: query language dựa trên facts, predicates và reusable rules; hỗ trợ recursion tự nhiên. Xem Datalog.
Mental model
Hình dạng dữ liệu + query quan trọng + cách dữ liệu thay đổi
                         ↓
                 chọn data model
                         ↓
     thao tác nào tự nhiên, thao tác nào trở nên khó
                         ↓
          query language và storage strategy
Không chọn database chỉ từ nhãn SQL hay NoSQL. Hãy bắt đầu bằng hình dạng quan hệ và access pattern mà hệ phải phục vụ.
Data model là một chuỗi abstraction
Một ứng dụng thường đi qua nhiều lớp biểu diễn:
Đối tượng nghiệp vụ trong application
-> JSON/XML/document/table/graph
-> bytes trong memory, disk hoặc network
-> tín hiệu điện
Mỗi lớp biểu diễn chính nó bằng lớp thấp hơn và che bớt độ phức tạp. Vì vậy, data model không chỉ là format lưu trữ; nó định hình cách developer suy nghĩ về bài toán. Các assumption của model khiến một số thao tác ngắn gọn và nhanh, nhưng khiến thao tác khác vụng về hoặc chậm.
Relational Model Versus Document Model
Relational model do Edgar Codd đề xuất năm 1970, biểu diễn dữ liệu thành relation; trong SQL, relation là table và mỗi table là một tập row không có thứ tự. Nó xuất phát từ business data processing như transaction ngân hàng, đặt vé, tồn kho, payroll và reporting, nhưng sau đó mở rộng tốt sang nhiều workload khác.
Đột phá quan trọng không chỉ là table. Relational model che internal representation và physical access path khỏi application. Developer mô tả dữ liệu cần lấy; database chịu trách nhiệm tìm cách lấy nó.
The Birth of NoSQL
Từ NoSQL ban đầu chỉ là hashtag cho một meetup năm 2009 về open-source, distributed, non-relational databases; nó không chỉ một công nghệ hay data model cụ thể. Về sau, tên này thường được diễn giải là Not Only SQL.
Bốn động lực được chương nêu:
- Cần scalability lớn hơn mức một số relational deployment dễ đạt được, gồm dataset rất lớn hoặc write throughput rất cao.
- Ưu tiên phần mềm free và open source thay cho commercial database product.
- Cần specialized query operation không được relational model hỗ trợ tốt.
- Không hài lòng với relational schema cứng và muốn data model linh hoạt, biểu đạt tốt hơn.
NoSQL không phải “relational model đã hết thời”
-> application có requirements khác nhau
-> model phù hợp cũng khác nhau
-> relational + non-relational cùng tồn tại
-> polyglot persistence
Lập luận của chương là coexistence, không phải replacement. Một hệ có thể dùng relational database cho transaction, document store cho aggregate và graph store cho relationship-heavy feature.
Nguồn: PDF, The Birth of NoSQL.
The Object-Relational Mismatch
Application hướng đối tượng tổ chức dữ liệu thành object, nested structure, collection và reference. Relational database dùng table, row, column và foreign key. Lớp chuyển đổi giữa hai cách biểu diễn được gọi là Object-Relational Mismatch.
ORM như ActiveRecord hoặc Hibernate giảm boilerplate mapping nhưng không thể làm hai model trở thành một. Application vẫn phải quyết định object nào là entity riêng, collection nào được load, relationship nào cần join và transaction boundary nằm ở đâu.
Ví dụ résumé
Một user có:
first_name,last_name,summary: xuất hiện một lần;- nhiều
positions; - nhiều
educationrecords; - nhiều loại
contact_info.
Trong relational model truyền thống:
users
  -> positions      qua user_id
  -> education      qua user_id
  -> contact_info   qua user_id
Trong document model, toàn bộ profile có thể là một JSON document. Cấu trúc one-to-many được biểu diễn trực tiếp thành nested array/object và gần với object structure của application hơn.
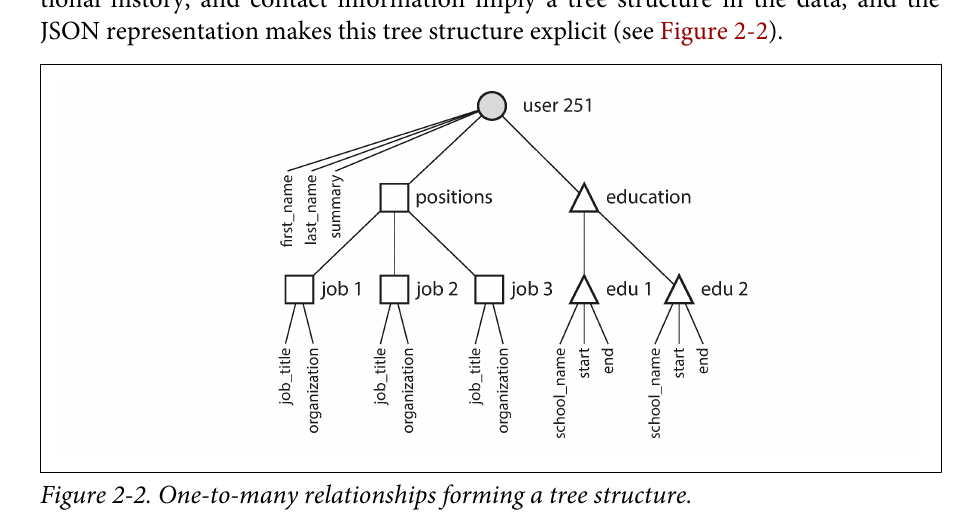
Hình 2-2: user 251 là root; positions, education và các field con tạo thành một tree. Đây là hình dạng mà document model biểu diễn tự nhiên. Nguồn: Designing Data-Intensive Applications, trang 32.
Ba cách lưu nested data trong relational database
- Chuẩn hóa thành table riêng và dùng foreign key.
- Dùng structured datatype, XML hoặc JSON type có hỗ trợ query/index bên trong.
- Encode JSON/XML thành text column và để application diễn giải; cách này thường làm database không query được field bên trong.
JSON document có hai lợi thế trong ví dụ này:
- Gần application model hơn: giảm phần translation giữa object và rows.
- Locality tốt hơn: đọc profile đầy đủ bằng một document thay vì nhiều query hoặc multi-way join.
Lợi thế chỉ mạnh khi profile thực sự là một document tự chứa. Nó không tự động áp dụng cho mọi domain dùng object-oriented code.
Nguồn: PDF, The Object-Relational Mismatch.
Many-to-One and Many-to-Many Relationships
Vì sao dùng ID thay cho text?
Trong résumé, region_id và industry_id được lưu thay cho chuỗi như Greater Seattle Area hoặc Philanthropy. Standardized ID mang lại:
- spelling và style nhất quán;
- tránh ambiguity giữa các địa danh trùng tên;
- đổi tên tại một nơi;
- localization theo ngôn ngữ người xem;
- search tốt hơn vì entity có thể chứa knowledge như Seattle thuộc Washington.
Text có ý nghĩa với con người
-> có thể đổi theo thời gian
-> nếu lặp ở nhiều record, mọi bản sao phải được cập nhật

ID không mang ý nghĩa hiển thị
-> có thể giữ ổn định
-> human-readable value chỉ lưu một nơi
Đây là mục tiêu của normalization: loại bỏ duplication của dữ liệu có ý nghĩa. Đổi lại, reference tạo ra quan hệ many-to-one: nhiều người cùng thuộc một region hoặc industry.
Tại sao document model bắt đầu gặp khó?
One-to-many tree không cần join vì child nằm trong parent document. Nhưng shared entity không còn thuộc riêng một document:
- nhiều profile tham chiếu cùng region;
- nhiều người từng làm tại cùng organization;
- nhiều người từng học cùng school;
- một recommendation nối người viết với người được nhận xét.
Nếu document database không hỗ trợ join tốt, application phải:
- đọc document chính;
- lấy các ID tham chiếu;
- gửi thêm query để lấy entity liên quan;
- tự ghép kết quả;
- hoặc cache/denormalize để tránh các query đó.
Việc join không biến mất; trách nhiệm chỉ chuyển từ database sang application.
Dữ liệu có xu hướng liên kết hơn theo thời gian
organization là string
-> organization có page, logo, news feed riêng
-> string trở thành reference tới entity

recommendation chứa tên và ảnh người viết
-> ảnh người viết có thể đổi
-> recommendation cần reference tới author profile
-> xuất hiện many-to-many relationship
Mỗi dotted group vẫn có thể là một document, nhưng đường nối giữa user, organization, school và recommendation phải được biểu diễn bằng reference và được resolve khi đọc. Vì vậy, thiết kế không chỉ nhìn data shape hôm nay mà phải dự đoán relationship growth khi feature tăng.
Nguồn: PDF, Many-to-One and Many-to-Many Relationships.
Are Document Databases Repeating History?
Tranh luận document versus relational lặp lại một vấn đề từ các database đầu tiên: biểu diễn many-to-many như thế nào mà không làm query code quá phức tạp?
Hierarchical model
IBM IMS biểu diễn toàn bộ dữ liệu thành tree của nested records, khá giống JSON document:
- mỗi record có đúng một parent;
- one-to-many hoạt động tốt;
- many-to-many khó biểu diễn;
- không hỗ trợ join;
- developer phải duplicate data hoặc tự resolve reference.
Những khó khăn của hierarchical model trong thập niên 1960–1970 gần với khó khăn document database gặp khi dữ liệu vượt khỏi một tree tự chứa.
Network model và CODASYL
CODASYL network model cho một record có nhiều parent, nhờ đó biểu diễn được many-to-one và many-to-many. Tuy nhiên, link giữa record giống pointer trên disk hơn foreign key.
Muốn tìm record, application phải đi từ root và lần theo một access path:
root record
-> pointer
-> record kế tiếp
-> chọn tiếp pointer
-> target record
Trong dữ liệu nhiều chiều, nhiều path có thể dẫn tới cùng record. Application phải giữ cursor, nhớ các relationship và tự chọn đường đi. Cách này tận dụng tốt hardware hạn chế thời đó nhưng làm query/update code phức tạp và inflexible. Khi access path thay đổi, nhiều handwritten query phải đổi theo.
Relational model thay đổi trách nhiệm
Relational model đặt row “ra ngoài ánh sáng”: application có thể chọn row bằng điều kiện bất kỳ, lookup key hoặc join relation mà không cần nhúng đường đi vật lý vào code.
CODASYL
application chọn access path
-> schema/path đổi
-> query code phải đổi

Relational
application khai báo điều kiện
-> optimizer chọn access path
-> thêm index không bắt buộc sửa query
Query optimizer rất phức tạp, nhưng chỉ cần được database vendor xây một lần và mọi application đều hưởng lợi. Đây là lợi thế dài hạn so với mỗi application tự hand-code access path.
Document database có thực sự quay lại CODASYL?
Document database quay lại hierarchical model ở việc nest one-to-many records trong parent. Nhưng với many-to-one/many-to-many, document reference về bản chất gần foreign key hơn pointer CODASYL:
- related entity được định danh bằng unique ID;
- ID được resolve lúc đọc bằng join hoặc follow-up query;
- application không bắt buộc phải traversal từ một root cố định.
Vì vậy, document database lặp lại một phần trade-off của hierarchical model, nhưng chưa quay lại access-path model của CODASYL.
Nguồn: PDF, Are Document Databases Repeating History?.
Relational Versus Document Databases Today
Trong phạm vi data model, document model thường được ủng hộ bởi:
- schema flexibility;
- locality có thể đem lại performance tốt;
- cấu trúc gần với application data hơn trong một số use case.
Relational model mạnh hơn ở:
- joins;
- many-to-one;
- many-to-many;
- query linh hoạt trên các entity liên kết.
Which data model leads to simpler application code?
Câu trả lời phụ thuộc vào hình dạng relationship.
| Data shape | Model tự nhiên hơn | Vì sao |
|---|---|---|
| Tree one-to-many, thường load cả tree | Document | Không cần “shred” aggregate thành nhiều table |
| Event record độc lập, hầu như không join | Document | Join limitation ít ảnh hưởng |
| Nhiều shared entity và many-to-many | Relational | Join được database xử lý trực tiếp |
| Relationship dày đặc, traversal nhiều hop | Graph | Relationship và path là abstraction chính |
Document model có một giới hạn giống access path: nested item thường không có identity độc lập; application có thể phải nói “position thứ hai của user 251”. Nếu nesting không quá sâu, điều này thường chấp nhận được.
Khi many-to-many xuất hiện, hai workaround phổ biến đều chuyển complexity sang application:
- Denormalize: đọc nhanh hơn nhưng phải giữ nhiều bản sao nhất quán.
- Application-side join: gửi nhiều database request, thường chậm hơn join được database tối ưu bên trong.
Do đó không thể tuyên bố model nào luôn cho code đơn giản hơn:
document-like data -> document model thường đơn giản
interconnected data -> document model trở nên awkward
relational model -> acceptable cho nhiều relationship
graph model -> tự nhiên nhất khi relationship là trọng tâm
Schema flexibility in the document model
Gọi document database là “schemaless” dễ gây hiểu nhầm. Reader vẫn giả định document có structure; schema chỉ không được database enforce lúc write.
| Schema-on-read | Schema-on-write | |
|---|---|---|
| Schema nằm ở đâu? | Implicit trong reader/application | Explicit trong database |
| Kiểm tra khi nào? | Khi đọc | Khi ghi |
| Tương tự type system | Dynamic/runtime checking | Static/compile-time checking |
| Điểm mạnh | Heterogeneous hoặc externally controlled data | Document và enforce structure đồng nhất |
Ví dụ đổi từ name sang first_name:
Schema-on-read
new writes dùng first_name
-> old document vẫn giữ name
-> reader phát hiện version cũ
-> tính first_name khi đọc
Schema-on-write
ALTER TABLE users ADD COLUMN first_name text;
UPDATE users SET first_name = split_part(name, ' ', 1);
Điểm cần tách bạch:
ALTER TABLEở nhiều relational database có thể hoàn thành nhanh vì chỉ đổi metadata; nguồn lưu ý MySQL thời điểm cuốn sách viết là ngoại lệ đáng kể.- Backfill bằng
UPDATEcó thể chậm ở mọi database vì phải rewrite từng row. - Nếu không thể backfill ngay, relational application cũng có thể để
first_name = NULLvà tính khi đọc, gần với schema-on-read.
Schema-on-read đặc biệt hợp khi:
- collection chứa nhiều loại object không thực tế để tách mỗi loại thành table;
- structure đến từ external system mà ta không kiểm soát và có thể đổi bất kỳ lúc nào.
Nếu mọi record được kỳ vọng có cùng structure, explicit schema lại là documentation và enforcement hữu ích.
Data locality for queries
Document thường được lưu thành một chuỗi liên tục như JSON, XML hoặc BSON. Khi application cần phần lớn document cùng lúc, locality giúp giảm nhiều index lookup và disk seek so với dữ liệu bị tách qua nhiều table.
Read toàn profile
-> document: một vùng dữ liệu, thường một query
-> normalized tables: nhiều index lookup hoặc join
Nhưng locality chỉ có lợi nếu access pattern khớp:
- Chỉ đọc một field nhỏ vẫn có thể phải load cả document.
- Update thường phải rewrite cả document.
- In-place update chỉ dễ khi encoded size không thay đổi.
- Document tăng không giới hạn làm read và write ngày càng đắt.
Nguyên tắc của nguồn: giữ document tương đối nhỏ và tránh write làm document liên tục phình ra.
Locality không thuộc độc quyền document database. Relational/other systems cũng có cơ chế colocate dữ liệu, như interleaved rows trong Spanner, multi-table index cluster trong Oracle và column family trong Bigtable-style systems.
Convergence of document and relational databases
Hai phía đang vay mượn khả năng của nhau:
- relational database bổ sung XML/JSON type, local update, index và query bên trong document;
- document database bổ sung relational-like join;
- driver có thể tự resolve document reference bằng client-side join, dù thường tốn thêm network round trip và ít tối ưu hơn database-side join.
Ngay từ mô tả relational model ban đầu, Codd đã cho phép nonsimple domains: giá trị trong row có thể là nested relation thay vì chỉ primitive value. Vì vậy, hybrid relational-document model không hoàn toàn trái với nền tảng relational.
Kết luận của chương:
Relational và document model bổ sung cho nhau. Database hỗ trợ document-like data đồng thời cho phép relational query giúp application chọn đúng abstraction cho từng phần của domain.
Nguồn: PDF, Relational Versus Document Databases Today.
Bảng quyết định relational hay document
| Câu hỏi | Nghiêng về document | Nghiêng về relational |
|---|---|---|
| Dữ liệu có hình dạng gì? | Tree/aggregate tự chứa | Network entity liên kết |
| Cardinality chính? | One-to-many | Many-to-one/many-to-many |
| Read pattern? | Đọc phần lớn document cùng lúc | Ghép nhiều entity theo nhiều cách |
| Entity con có identity riêng? | Ít hoặc không | Có và được nhiều nơi tham chiếu |
| Schema variation? | Heterogeneous/external data | Record cần chung contract |
| Update pattern? | Thay cả aggregate, document nhỏ | Cập nhật độc lập từng entity |
| Query mới có thường xuất hiện? | Access pattern khá ổn định | Cần ad-hoc query/join linh hoạt |
Kết luận cần nhớ
Đừng hỏi: SQL hay NoSQL tốt hơn?

Hãy hỏi:
1. Aggregate boundary nằm ở đâu?
2. Quan hệ có còn là tree khi feature tăng không?
3. Join được xử lý bởi database hay bị đẩy sang application?
4. Schema được enforce khi write hay diễn giải khi read?
5. Locality có khớp read/update pattern thật không?
Query Languages for Data
Relational model không chỉ đưa ra cách biểu diễn dữ liệu mới; nó còn thay đổi cách application yêu cầu dữ liệu. SQL là Declarative Query Language, trong khi IMS và CODASYL dùng imperative query API.
Declarative và imperative
Giả sử cần lấy các animal thuộc family Sharks.
Imperative code mô tả cả thuật toán:
khởi tạo result rỗng
-> duyệt từng animal theo thứ tự
-> kiểm tra family
-> nếu là Sharks thì append vào result
-> trả result
SQL chỉ mô tả điều kiện của kết quả:
SELECT * FROM animals WHERE family = 'Sharks';Khác biệt cốt lõi:
| Imperative | Declarative |
|---|---|
| Chỉ rõ operation và execution order | Chỉ rõ pattern của kết quả |
| Application quyết định cách traversal | Database chọn execution strategy |
| Dễ phụ thuộc vào record order | Không đảm bảo order nếu không yêu cầu rõ |
| Thay cách thực thi có thể phải sửa code | Engine có thể tối ưu mà giữ nguyên query |
Trong declarative query, application vẫn mô tả filter, transform, sort, group hoặc aggregate mong muốn. Nó chỉ không quy định database phải dùng index nào, join method nào hay chạy các phần theo thứ tự nào.
Vì sao declarative query có giá trị?
- Ngắn và gần intent: query tập trung vào dữ liệu cần lấy.
- Che implementation detail: storage engine có thể di chuyển record hoặc đổi layout mà không phá query.
- Cho optimizer không gian lựa chọn: database tự chọn index, join order và algorithm.
- Cho phép cải thiện performance mà không đổi application: engine mới có thể chạy cùng query hiệu quả hơn.
- Có cơ hội parallelize tốt hơn: query nói kết quả cần thỏa gì thay vì khóa cứng sequence thao tác.
Imperative code rất khó tự động parallelize vì thứ tự instruction có thể mang ý nghĩa. Declarative query để engine chọn parallel implementation nếu semantics cho phép.
Nguồn: PDF, Query Languages for Data.
Declarative Queries on the Web
Lợi ích của declarative language không chỉ xuất hiện trong database. CSS và XPath áp dụng cùng mental model cho document trong browser.
Giả sử navigation có một list item được đánh dấu:
<li class="selected"><p>Sharks</p></li>Muốn title của item đang chọn có background xanh, CSS chỉ cần khai báo pattern:
li.selected > p { background-color: blue; }Selector nói: áp dụng style cho mọi <p> là direct child của <li class="selected">. Nó không mô tả cách browser tìm node hay thứ tự duyệt DOM.
XPath/XSL cũng làm điều tương tự bằng một pattern tương đương:
li[@class='selected']/pNếu làm imperatively bằng DOM API
Application phải tự:
lấy mọi <li>
-> lặp qua từng node
-> kiểm tra className
-> lặp qua childNodes
-> kiểm tra node type và tag name
-> set style trực tiếp
Vấn đề không chỉ là code dài hơn:
- Nếu class
selectedbị gỡ, style đã set trực tiếp không tự biến mất; code phải có logic cleanup riêng. - Khi API duyệt DOM tốt hơn xuất hiện, application phải được viết lại để tận dụng nó.
- Code imperative trộn điều kiện cần đúng với cách tìm và sửa node.
Với CSS:
DOM thay đổi
-> browser đánh giá lại selector
-> rule không còn match
-> style tự được gỡ
Browser vendor cũng có thể tối ưu CSS/XPath engine mà không phá stylesheet. Đây chính là lợi ích database nhận được từ SQL: declarative interface tạo một boundary ổn định giữa intent của application và execution của engine.
Mental model
Declarative rule
-> mô tả invariant/pattern cần đúng
-> runtime liên tục duy trì kết quả khi underlying data thay đổi

Imperative mutation
-> tạo ra state tại một thời điểm
-> application phải tự xử lý mọi thay đổi tiếp theo
Nguồn: PDF, Declarative Queries on the Web.
MapReduce Querying
MapReduce là programming model để xử lý lượng dữ liệu lớn theo batch trên nhiều machine. Một số NoSQL datastore từng cung cấp dạng MapReduce giới hạn để thực hiện read-only query trên nhiều document.
MapReduce nằm giữa declarative và imperative:
- Imperative-like: developer viết code cho
mapvàreduce. - Framework-controlled: runtime quyết định function chạy ở machine nào, theo thứ tự nào và khi nào cần chạy lại.
- Không hoàn toàn declarative: optimizer khó hiểu intent bên trong arbitrary code hơn một SQL expression.
Luồng xử lý
Input records
-> map(record)
-> emit(key, value)
-> framework group mọi value theo key
-> reduce(key, values)
-> output aggregate cho từng key
map còn được gọi là collect; reduce còn được gọi là fold hoặc inject trong functional programming.
Ví dụ: đếm số shark sighting theo tháng
Input observation có:
- thời điểm quan sát;
- animal family;
- số animal nhìn thấy.
Mục tiêu là lọc family Sharks, gom theo tháng và cộng numAnimals.
SQL mô tả trực tiếp filter, group và sum:
SELECT month, SUM(num_animals)
FROM observations
WHERE family = 'Sharks'
GROUP BY month;
MapReduce chia logic thành hai bước:
map(observation)
-> key = year-month
-> value = numAnimals
-> emit(key, value)

reduce(year-month, all values)
-> sum(values)
Ví dụ hai record trong tháng 1995-12 có value 3 và 4:
map -> emit("1995-12", 3)
map -> emit("1995-12", 4)
group -> ("1995-12", [3, 4])
reduce -> 7
Tại sao map và reduce phải là pure functions?
Nguồn yêu cầu các function:
- chỉ dùng input được truyền vào;
- không query thêm database;
- không tạo side effect.
Các giới hạn này cho phép framework:
chạy function ở bất kỳ machine nào
+ chạy theo bất kỳ thứ tự nào
+ retry khi machine/function thất bại
-> vẫn giữ cùng semantics
Function vẫn có thể parse string, tính toán hoặc gọi library function, miễn là output chỉ phụ thuộc vào input.
MapReduce có đồng nghĩa với distributed query không?
Không. MapReduce là một low-level programming model cho distributed execution, nhưng:
- SQL có thể được triển khai bằng pipeline MapReduce;
- distributed SQL cũng có thể chạy mà không dùng MapReduce;
- bản thân SQL không bị giới hạn ở một machine.
Phân tán là property của execution engine, không phải đặc quyền của một query syntax.
Hạn chế về usability và optimization
Để thực hiện một aggregate, developer phải viết hai function phối hợp chính xác. Cách này thường khó đọc và khó kiểm tra hơn một query duy nhất.
Ngoài ra:
- optimizer nhìn thấy rõ cấu trúc của declarative query;
- optimizer khó suy luận arbitrary JavaScript trong
map/reduce; - ít cơ hội rewrite hoặc reorder operation tự động hơn.
Đó là lý do MongoDB bổ sung aggregation pipeline. Cùng bài toán shark sightings được biểu diễn thành các stage:
$match family = Sharks
-> $group theo year + month
-> $sum numAnimals
Aggregation pipeline có syntax JSON nhưng khả năng biểu đạt gần một subset của SQL. Bài học của chương: một NoSQL system có thể dần tái tạo các ý tưởng của declarative relational query dưới hình thức khác.
Bảng so sánh
| SQL / aggregation pipeline | MapReduce | |
|---|---|---|
| Mức khai báo | Cao | Ở giữa declarative và imperative |
| Logic user viết | Expression/stages | Code trong map và reduce |
| Optimizer hiểu intent | Tốt hơn | Hạn chế hơn |
| Distributed execution | Có thể | Thiết kế trực tiếp cho cluster |
| Retry an toàn | Engine quản lý | Dựa vào pure functions |
| Query đơn giản | Ngắn, dễ đọc | Thường dài và phối hợp nhiều phần |
Nguồn: PDF, MapReduce Querying.
Kết luận cần nhớ
Declarative query
-> application nói “muốn gì”
-> engine quyết định “làm thế nào”
-> dễ tối ưu và parallelize hơn

MapReduce
-> developer cung cấp pure computation
-> framework quyết định placement, grouping và retry
-> mạnh cho distributed batch
-> nhưng low-level và khó tối ưu hơn declarative query
Graph-Like Data Models
Graph model trở nên tự nhiên khi many-to-many relationship rất phổ biến và connection giữa các record phức tạp hơn một tập join cố định.
Ít relationship hoặc one-to-many tree
-> document model

Many-to-many tương đối rõ và query bằng join cố định
-> relational model

Relationship dày đặc + traversal/path là câu hỏi chính
-> graph model
Graph có hai loại object:
- Vertex: node/entity.
- Edge: relationship/arc nối các vertex.
Ví dụ:
| Graph | Vertex | Edge |
|---|---|---|
| Social graph | Person | knows |
| Web graph | Web page | hyperlink |
| Road network | Junction | road |
Graph không bắt buộc homogeneous. Một datastore có thể cùng lúc chứa person, location, event, check-in và comment; edge biểu diễn friendship, attendance, location hoặc authorship.
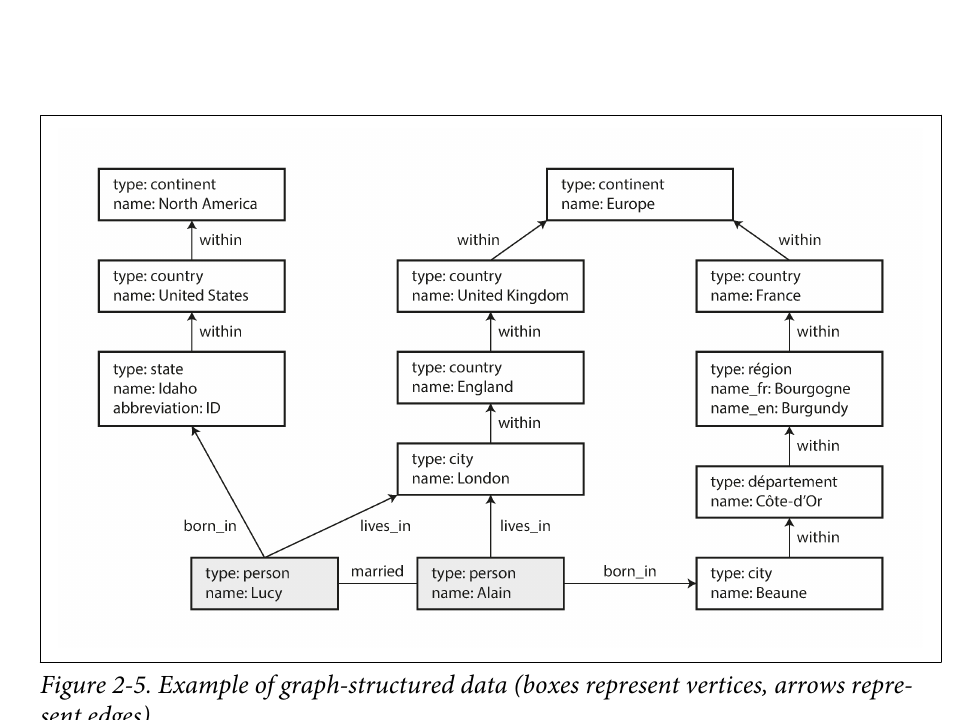
Hình 2-5: Lucy sinh ở Idaho, Alain sinh ở Beaune, hai người kết hôn và sống tại London. Location hierarchy của Mỹ, Anh và Pháp có độ sâu và loại đơn vị khác nhau nhưng cùng được biểu diễn bằng vertex và edge within. Nguồn: Designing Data-Intensive Applications, trang 50.
Nguồn: PDF, Graph-Like Data Models.
Property Graphs
Trong Property Graph, mỗi vertex gồm:
- unique identifier;
- tập outgoing edges;
- tập incoming edges;
- key-value properties.
Mỗi edge gồm:
- unique identifier;
- tail vertex, nơi edge bắt đầu;
- head vertex, nơi edge kết thúc;
- label mô tả loại relationship;
- key-value properties.
Có thể lưu property graph trong relational schema
Mô hình tối giản gồm hai table:
vertices(vertex_id, properties)
edges(edge_id, tail_vertex, head_vertex, label, properties)
Hai index trên tail_vertex và head_vertex cho phép tìm outgoing/incoming edges và traversal theo cả hai hướng.
Điều này cho thấy logical data model không đồng nhất với physical storage model. Graph có thể được lưu bằng relational tables; câu hỏi thực tế là query language và execution engine có làm traversal tự nhiên, hiệu quả hay không.
Ba đặc tính quan trọng
- Bất kỳ vertex nào cũng có thể nối với bất kỳ vertex nào; schema không ép loại entity nào được liên kết.
- Từ một vertex có thể tìm incoming và outgoing edge để traversal forward hoặc backward.
- Edge label cho phép nhiều loại relationship cùng tồn tại mà model vẫn rõ ràng.
Tại sao graph có evolvability tốt?
Ví dụ location của Lucy và Alain có granularity khác nhau:
- birthplace của Lucy chỉ đến state;
- residence đến city;
- Pháp có
départementvàrégion; - Anh có country nằm trong country theo model của ví dụ.
Graph không cần ép mọi location vào một hierarchy cố định. Khi thêm feature về allergy và food:
Person ->[ALLERGIC_TO]-> Allergen
Food   ->[CONTAINS]->    Allergen
Ta thêm vertex/edge mới mà không phải tái cấu trúc relationship hiện có. Sau đó có thể query food an toàn cho từng person.
Nguồn: PDF, Property Graphs.
The Cypher Query Language
Cypher Query Language là declarative query language cho property graph. Cú pháp mũi tên mô tả trực tiếp vertex, hướng và loại edge.
Tạo vertex và edge
(Idaho:Location {name: 'Idaho'})
(USA:Location {name: 'United States'})
(Idaho)-[:WITHIN]->(USA)(Idaho)là vertex được gán symbolic name trong query.:Locationlà label/type của vertex.{name: ...}là property.[:WITHIN]là relationship label.- Mũi tên cho biết tail và head vertex.
Query xuyên suốt chương
Tìm người sinh tại Mỹ nhưng đang sống ở châu Âu:
MATCH
  (person)-[:BORN_IN]->()-[:WITHIN*0..]->(us:Location {name:'United States'}),
  (person)-[:LIVES_IN]->()-[:WITHIN*0..]->(eu:Location {name:'Europe'})
RETURN person.name
Đọc query theo hai điều kiện trên cùng person:
- Đi theo
BORN_IN, rồi zero-or-more edgeWITHIN, cuối cùng tớiUnited States. - Đi theo
LIVES_IN, rồi zero-or-more edgeWITHIN, cuối cùng tớiEurope.
*0.. là variable-length traversal, tương tự * trong regular expression. Nó cho phép location ban đầu có thể là street, city, state hoặc country mà query không cần biết trước số tầng.
Declarative ở điểm nào?
Query không bắt buộc engine bắt đầu từ person. Optimizer có thể:
- scan person rồi kiểm tra birthplace/residence; hoặc
- dùng index tìm vertex
United StatesvàEurope, traversal ngược các incomingWITHINedges, rồi tìm person quaBORN_INvàLIVES_IN.
Application mô tả graph pattern; optimizer chọn execution path được dự đoán hiệu quả hơn.
Nguồn: PDF, The Cypher Query Language.
Graph Queries in SQL
Graph data lưu trong vertices và edges vẫn query được bằng SQL. Khó khăn xuất hiện khi số edge cần traversal không biết trước.
Fixed joins và variable-length traversal
Trong relational query thông thường, developer biết trước cần bao nhiêu join. Với location graph:
person
-> LIVES_IN city?
-> WITHIN district?
-> WITHIN region?
-> WITHIN country?
-> WITHIN continent?
Số tầng thay đổi theo từng record. Cypher nén điều này thành [:WITHIN*0..].
Từ SQL:1999, SQL có thể biểu diễn recursion bằng WITH RECURSIVE. Cùng bài toán được chia thành các derived sets:
in_usa
-> seed bằng vertex United States
-> lặp theo incoming WITHIN để lấy mọi location thuộc Mỹ

in_europe
-> seed bằng vertex Europe
-> lặp theo incoming WITHIN để lấy mọi location thuộc châu Âu

born_in_usa
-> follow incoming BORN_IN từ in_usa

lives_in_europe
-> follow incoming LIVES_IN từ in_europe

result
-> intersection born_in_usa và lives_in_europe
Recursive CTE có hai phần:
WITH RECURSIVE in_usa(vertex_id) AS (
  SELECT ...                         -- base case
  UNION
  SELECT ... JOIN in_usa ...         -- recursive step
)- Base case: bắt đầu từ vertex có tên
United States. - Recursive step: thêm mọi tail vertex có edge
withintrỏ vào vertex đã biết. - Lặp đến khi không tìm thấy vertex mới.
SQL làm được cùng query nhưng dài hơn đáng kể. Bài học không phải SQL “không query được graph”, mà là abstraction của query language quyết định use case nào được biểu đạt tự nhiên.
Cùng dữ liệu + cùng kết quả
Cypher: pattern/path là first-class
SQL: phải tự dựng recursion và intermediate sets
Nguồn: PDF, Graph Queries in SQL.
Triple-Stores and SPARQL
Triple Store gần tương đương property graph nhưng dùng vocabulary khác. Mọi thông tin được lưu thành:
(subject, predicate, object)Ví dụ:
(lucy, age, 33)
(lucy, marriedTo, alain)
Ánh xạ sang property graph
Subject luôn tương đương một vertex. Object có hai trường hợp:
| Triple object | Ý nghĩa | Property graph tương đương |
|---|---|---|
| Primitive value | Thuộc tính của subject | property key/value |
| Vertex khác | Quan hệ giữa hai entity | labeled edge |
(lucy, age, 33)
-> vertex lucy có property age = 33

(lucy, marriedTo, alain)
-> edge marriedTo từ lucy tới alain
Turtle và RDF
Turtle là human-readable format cho RDF triples. Semicolon cho phép gom nhiều predicate có cùng subject:
_:lucy  a :Person;
        :name "Lucy";
        :bornIn _:idaho.
RDF thường dùng URI cho subject/predicate/object vì được thiết kế để ghép dữ liệu từ nhiều nguồn. Namespace giúp hai tổ chức cùng dùng từ within nhưng mang nghĩa khác mà không collision.
URI trong RDF chỉ cần là identifier/namespace; nó không nhất thiết resolve thành web page.
Triple-store không phụ thuộc semantic web. Dù ý tưởng semantic web toàn cầu không thành công như kỳ vọng ban đầu, triple vẫn có thể là internal data model hữu ích cho application.
SPARQL
SPARQL là declarative query language cho RDF triple-store. Nó match graph bằng triple patterns; variable bắt đầu bằng ?.
Cùng query di cư:
PREFIX : <urn:example:>
SELECT ?personName WHERE {
  ?person :name ?personName.
  ?person :bornIn  / :within* / :name "United States".
  ?person :livesIn / :within* / :name "Europe".
}
So với Cypher:
Cypher: (person)-[:BORN_IN]->()-[:WITHIN*0..]->(location)
SPARQL: ?person :bornIn / :within* ?location
RDF không phân biệt property và edge; cả hai đều là predicate. Vì vậy SPARQL dùng cùng syntax để match relationship và scalar property.
Nguồn: PDF, Triple-Stores and SPARQL.
Graph Databases Compared to the Network Model
Graph database hiện đại không phải CODASYL quay lại:
| CODASYL network model | Graph database |
|---|---|
| Schema giới hạn record type nào được nest | Bất kỳ vertex nào cũng có thể nối với vertex khác |
| Chỉ tới record bằng access path | Lookup trực tiếp bằng ID/index hoặc traversal |
| Child records có thứ tự lưu trữ | Vertex và edge không có thứ tự cố định |
| Query imperative, dễ vỡ khi schema đổi | Có declarative query như Cypher/SPARQL |
Điểm khác biệt lớn là graph model tách logical relationship khỏi một access path bắt buộc.
The Foundation: Datalog
Datalog được nghiên cứu từ thập niên 1980 và là nền tảng cho nhiều query language về sau. Data model của nó gần triple-store nhưng tổng quát hơn.
Từ triple thành predicate
Triple:    (subject, predicate, object)
Datalog:  predicate(subject, object)
Ví dụ facts:
name(usa, 'United States').
within(idaho, usa).
name(lucy, 'Lucy').
born_in(lucy, idaho).
Facts là dữ liệu đã lưu. Predicate như name, within, born_in mô tả relationship hoặc property.
Rule và derived predicate
within_recursive(Location, Name) :- name(Location, Name).

within_recursive(Location, Name) :-
    within(Location, Via),
within_recursive(Via, Name).- Bên phải
:-là các điều kiện cần match. - Bên trái là fact mới có thể suy ra.
- Tên bắt đầu bằng chữ hoa là variable.
- Derived predicate không nhất thiết được lưu; nó được suy ra từ facts và rules.
Recursion hoạt động thế nào?
Với facts within(idaho, usa) và within(usa, namerica):
name(namerica, 'North America')
-> within_recursive(namerica, 'North America')

within(usa, namerica)
+ fact vừa suy ra
-> within_recursive(usa, 'North America')

within(idaho, usa)
+ fact vừa suy ra
-> within_recursive(idaho, 'North America')
Rule được áp dụng lặp lại, nhờ đó Datalog tìm transitive relationship mà không hard-code số hop.
Xây query phức tạp từng bước
Một rule migrated có thể kết hợp:
- tên của person;
- birthplace;
- recursive containment của birthplace;
- residence;
- recursive containment của residence.
Sau đó query:
?- migrated(Who, 'United States', 'Europe').để tìm binding phù hợp cho Who.
Cypher và SPARQL đi thẳng vào MATCH/SELECT; Datalog định nghĩa các building block trước rồi kết hợp. Nó kém tiện cho one-off query đơn giản nhưng mạnh khi data và logic phức tạp vì rules có thể tái sử dụng.
Nguồn: PDF, The Foundation: Datalog.
So sánh cùng một traversal
| Language | Abstraction chính | Cách biểu diễn WITHIN nhiều hop |
|---|---|---|
| Cypher | Vertex-edge pattern | [:WITHIN*0..] |
| SQL | Relation và derived set | Recursive CTE |
| SPARQL | Triple pattern/property path | :within* |
| Datalog | Facts và rules | Recursive rule |
Cypher/SPARQL
-> nói trực tiếp path cần match

SQL
-> xây tập kết quả lặp bằng recursive CTE

Datalog
-> định nghĩa quan hệ suy diễn rồi tái sử dụng
Kết luận cần nhớ
- Graph model phù hợp khi relationship và traversal là dữ liệu chính, không chỉ metadata phụ.
- Property graph và triple-store gần tương đương về khả năng biểu diễn nhưng dùng vocabulary khác.
- Graph có thể lưu trong relational tables; sự khác biệt lớn nằm ở abstraction và query ergonomics.
- Variable-length path là điểm khiến Cypher/SPARQL/Datalog tự nhiên hơn SQL thông thường.
- Declarative graph query mô tả pattern; optimizer vẫn được tự chọn execution path.
- Datalog đổi sự tiện lợi của one-off query lấy khả năng composition, recursion và reuse.
Bảng quyết định nhanh
| Tình huống | Model khởi đầu hợp lý | Câu hỏi kiểm tra |
|---|---|---|
| Profile/order/content được đọc như một khối | Document | Có thường cần join với entity ngoài document không? |
| Transaction và entity liên kết rõ | Relational | Query có cần traversal sâu không biết trước không? |
| Quan hệ là dữ liệu chính | Graph | Có thường tìm path, neighborhood hoặc nhiều hop không? |
| Dữ liệu không đồng nhất | Schema-on-read | Reader có xử lý được version và validation không? |
| Cần invariant chặt | Schema-on-write | Migration có được vận hành an toàn không? |
Summary
Lịch sử data model đi từ một cây lớn sang relational model để xử lý many-to-many. Các NoSQL model hiện đại tách theo hai hướng gần như đối lập:
- Document database tối ưu cho document tự chứa, ít quan hệ giữa các document.
- Graph database tối ưu cho dữ liệu nơi mọi thứ có thể liên hệ với nhau.
Không có model thắng tuyệt đối. Một model có thể mô phỏng model khác, nhưng query và implementation thường trở nên vụng về. Câu hỏi đúng là: model nào làm cho relationship và query quan trọng nhất của ứng dụng trở nên trực tiếp nhất, trong khi vẫn chịu được cách dữ liệu sẽ tiến hóa?
Ngoài ba model này còn nhiều model chuyên biệt như sequence-similarity search, large-scale physics analysis và full-text search. Không một general-purpose database nào tối ưu cho mọi loại dữ liệu.
Khi áp dụng
- Khi thiết kế schema mới, vẽ relationship cardinality trước khi chọn datastore.
- Khi một document ngày càng chứa nhiều ID tham chiếu, đánh giá lại chi phí join và consistency.
- Khi SQL recursive CTE trở thành phần chính của workload, cân nhắc graph model.
- Khi chọn schema-on-read, viết rõ validation, versioning và migration nằm ở reader nào.
- Khi query performance kém, kiểm tra liệu vấn đề là index hay chính data model không phù hợp.
Câu hỏi review
- Vì sao data model ảnh hưởng đến cách ta suy nghĩ về bài toán?
- Object-relational mismatch là gì, và document model giảm mismatch đó như thế nào?
- Vì sao one-to-many phù hợp với document tree nhưng many-to-many làm model này phức tạp?
- Schema-on-read khác schema-on-write ở đâu? “Schemaless” gây hiểu nhầm như thế nào?
- Data locality của document đem lại lợi ích và chi phí gì?
- Declarative query language trao quyền tối ưu nào cho database?
- MapReduce nằm ở đâu giữa declarative và imperative?
- Khi nào property graph tự nhiên hơn relational model?
- Property graph và triple-store tương đương nhau ở điểm nào?
- Vì sao Datalog phù hợp với logic graph phức tạp và tái sử dụng?
Gợi ý trả lời câu hỏi review
- Model cung cấp vocabulary và constraint; nó làm một số representation/query tự nhiên, đồng thời che hoặc làm khó các cách khác.
- Object graph có nesting và collection, còn relational dùng row/table/reference. Document lưu nested aggregate gần cấu trúc object và giảm lớp chuyển đổi khi đọc cả aggregate.
- One-to-many tạo cây với một parent rõ ràng. Many-to-many khiến entity được nhiều document chia sẻ, dẫn tới reference, join hoặc duplication cần đồng bộ.
- Schema-on-write enforce trước khi lưu; schema-on-read diễn giải khi đọc. “Schemaless” sai vì application vẫn giả định một cấu trúc, chỉ là schema không do database cưỡng chế khi ghi.
- Locality giảm I/O và round trip khi đọc toàn document; nó lãng phí khi chỉ cần một phần nhỏ, và update có thể phải rewrite document lớn.
- Database được tự chọn index, join order, execution strategy và parallelism mà không đổi query contract.
- Framework điều phối execution như một hệ declarative, nhưng developer vẫn viết imperative-like logic trong pure map/reduce functions.
- Khi relationship đa dạng, many-to-many dày đặc, và query chủ yếu là traversal nhiều hop hoặc độ sâu không cố định.
- Vertex tương ứng subject; property là predicate + primitive object; edge là predicate nối subject tới object vertex.
- Datalog cho phép định nghĩa derived predicate bằng rules, kết hợp và recursion; logic phức tạp được xây từng bước và dùng lại.
Liên kết
- Book: Designing Data-Intensive Applications
- Daily reading: 24-09-2026 · 25-09-2026
- Concepts: Data Model · Document Store · Relational Database Design · Database Schema Design · Declarative Query Language · MapReduce · Graph Data Model · Property Graph · Cypher Query Language · Triple Store · Datalog
- PDF: Bắt đầu Chapter 2 trong PDF